Recap OpenInfra & Cloud Native Day Vietnam 2025: HAMi, Fractional GPU cho AI hiệu quả trong Cloud Native
Hai tháng sau khi so sánh các lựa chọn, bọn mình chọn HAMi. Lần này talk mở nó ra xem bên trong: pod nhận một phần GPU thế nào, phần đó được ép ra sao, và trông như thế nào trong một Kubeflow notebook.
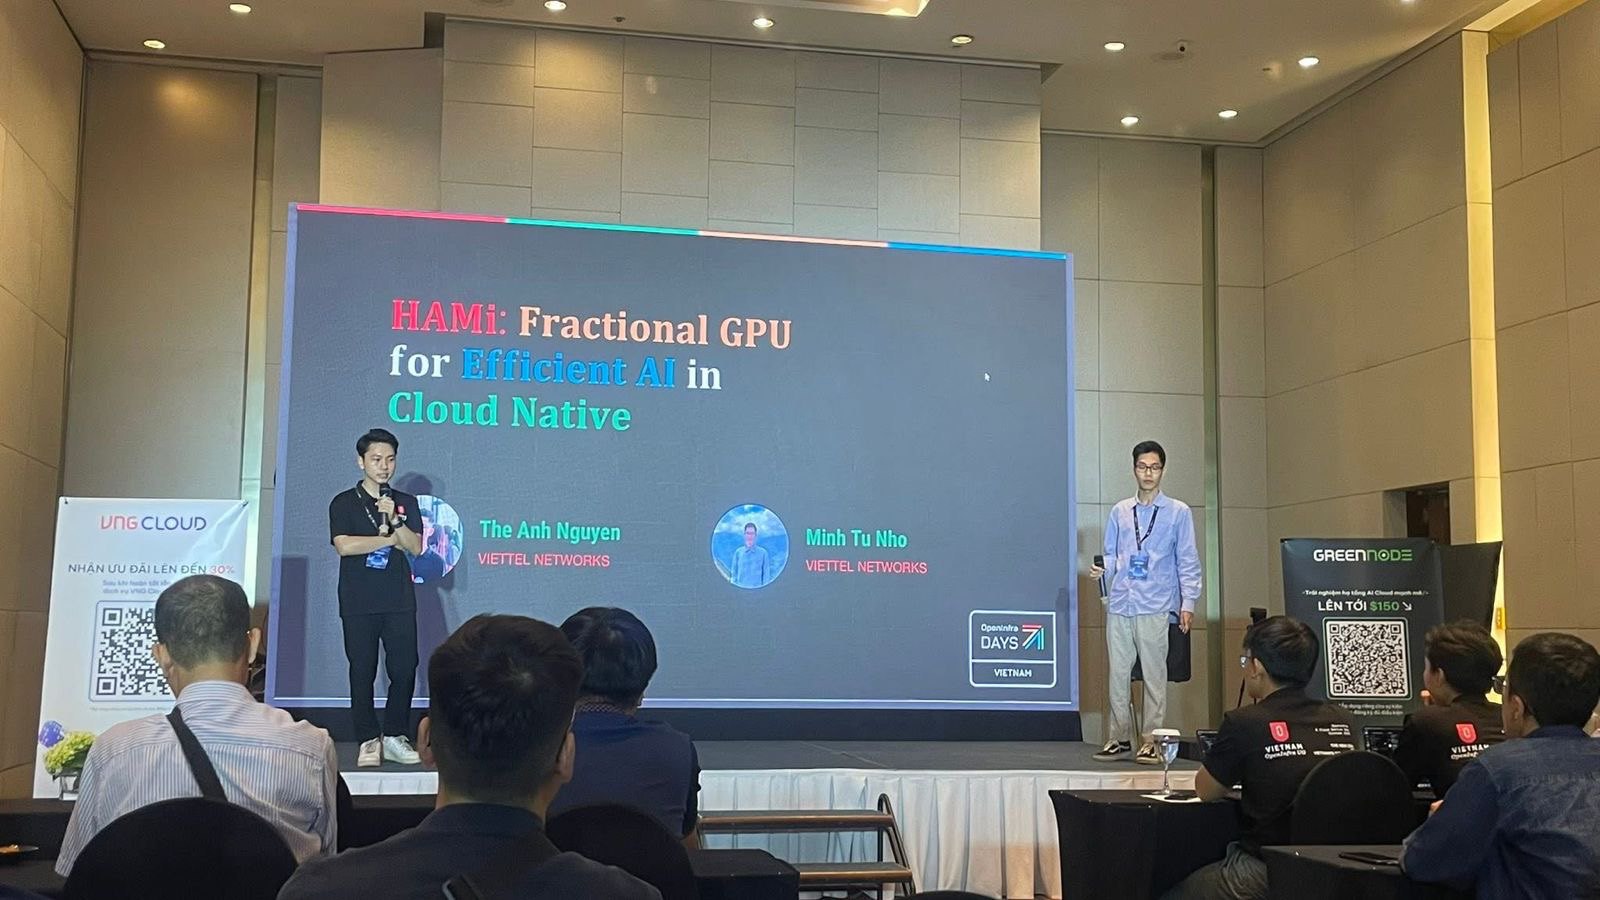
Hồi tháng 5, mình và anh Nho Minh Tú, cùng team, đã so sánh ba cách mã nguồn mở để chia sẻ GPU trên Kubernetes ở một buổi meetup của Cloud Native Hanoi (recap). Đến tháng 7 thì bọn mình đã chọn xong. Ở OpenInfra & Cloud Native Day Vietnam 2025 tại Hà Nội ngày 26/7, bọn mình trình bày phần tiếp theo: vì sao chọn HAMi, nó thực sự hoạt động thế nào, và người dùng GPU nhìn thấy gì.
Khác gì so với tháng 5
Nửa đầu vẫn là phần nền như lần trước nhưng gọn hơn: fractional GPU là gì, các cơ chế chia sẻ GPU của CUDA, và cách công cụ cloud native xếp lịch và giám sát workload GPU. Phần còn lại thì đi xa hơn ở bốn điểm:
- Bỏ hẳn nhánh ClearML. Tháng 5 bọn mình đề xuất ghép KAI Scheduler với các container giới hạn memory của ClearML. Lần này talk đi thẳng từ giới hạn của KAI sang HAMi.
- Soft isolation và hard isolation trở thành lập luận chính chứ không còn là một chú thích.
- Mở HAMi ra xem bên trong: webhook, scheduler, device plugin và HAMi Core, mỗi phần một slide.
- Ý tưởng Kubeflow thành giao diện chạy được. Tháng 5 nó chỉ là một slide “HAMi + Kubeflow”, còn tháng 7 bọn mình cho xem form tạo notebook có chỗ chọn phần GPU.
KAI Scheduler: chia thì dễ, cô lập thì mềm
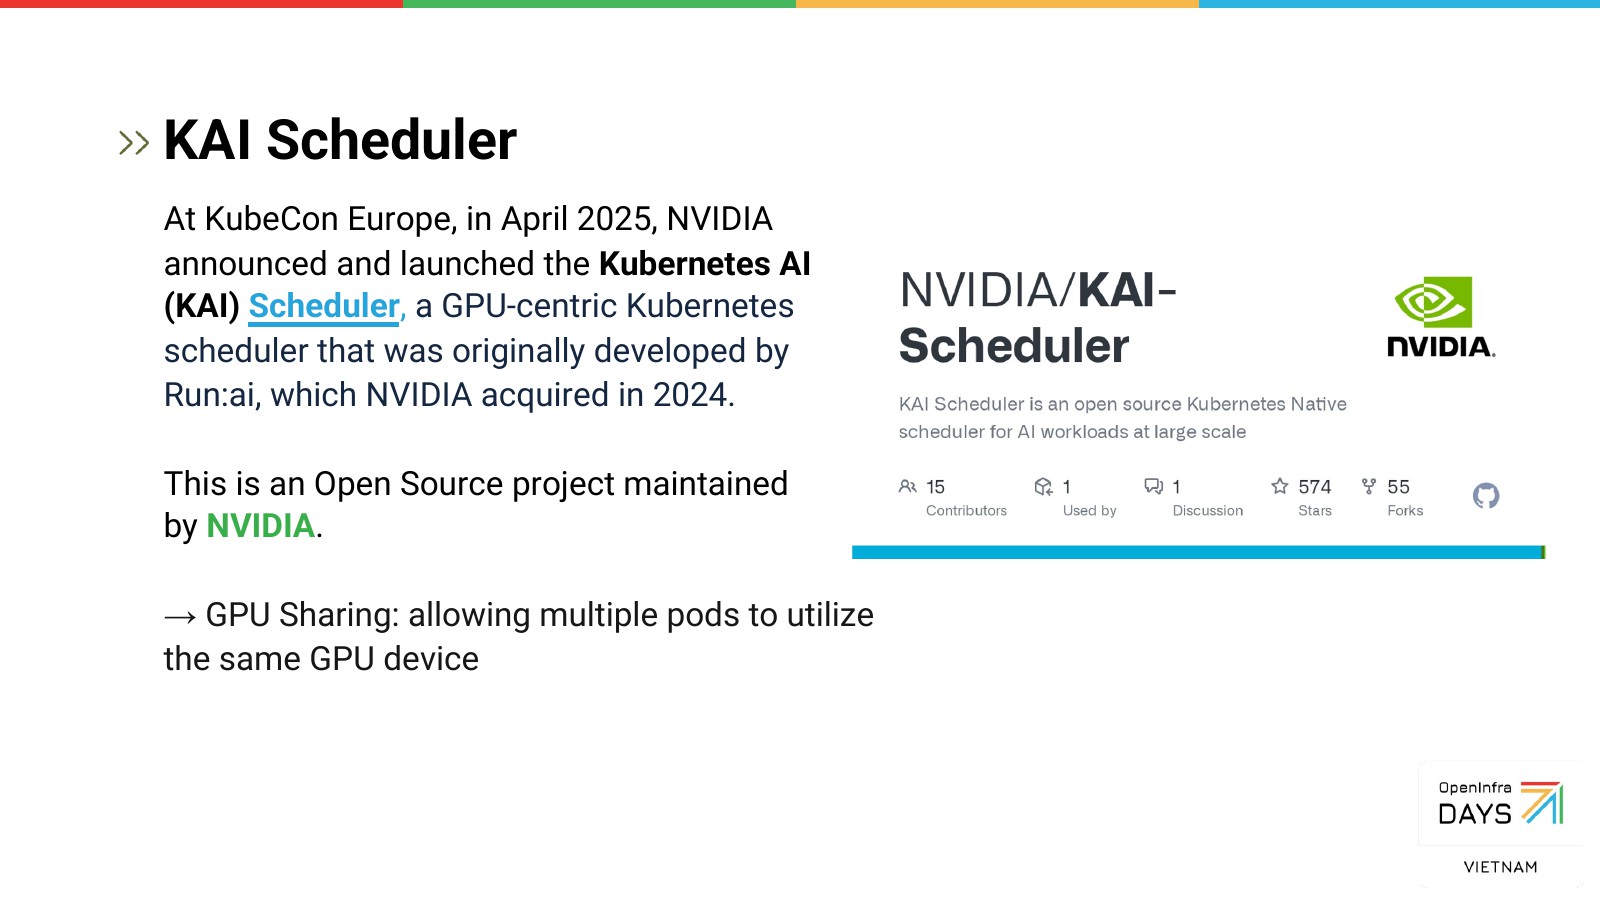
Ở KubeCon Europe tháng 4/2025, NVIDIA open source KAI Scheduler,
một scheduler Kubernetes xoay quanh GPU do Run:ai phát triển, công ty mà NVIDIA mua lại năm 2024. Nó cho
nhiều pod dùng chung một GPU, theo fraction (gpu-fraction) hoặc theo memory (gpu-memory).
Vướng mắc vẫn là cái bọn mình gặp hồi tháng 5: KAI xếp pod theo phần chúng xin nhưng không ép phần đó, nên
isolation chỉ là mềm. Xin nửa GPU mà nvidia-smi trong pod vẫn thấy nguyên card
(#49,
#45).
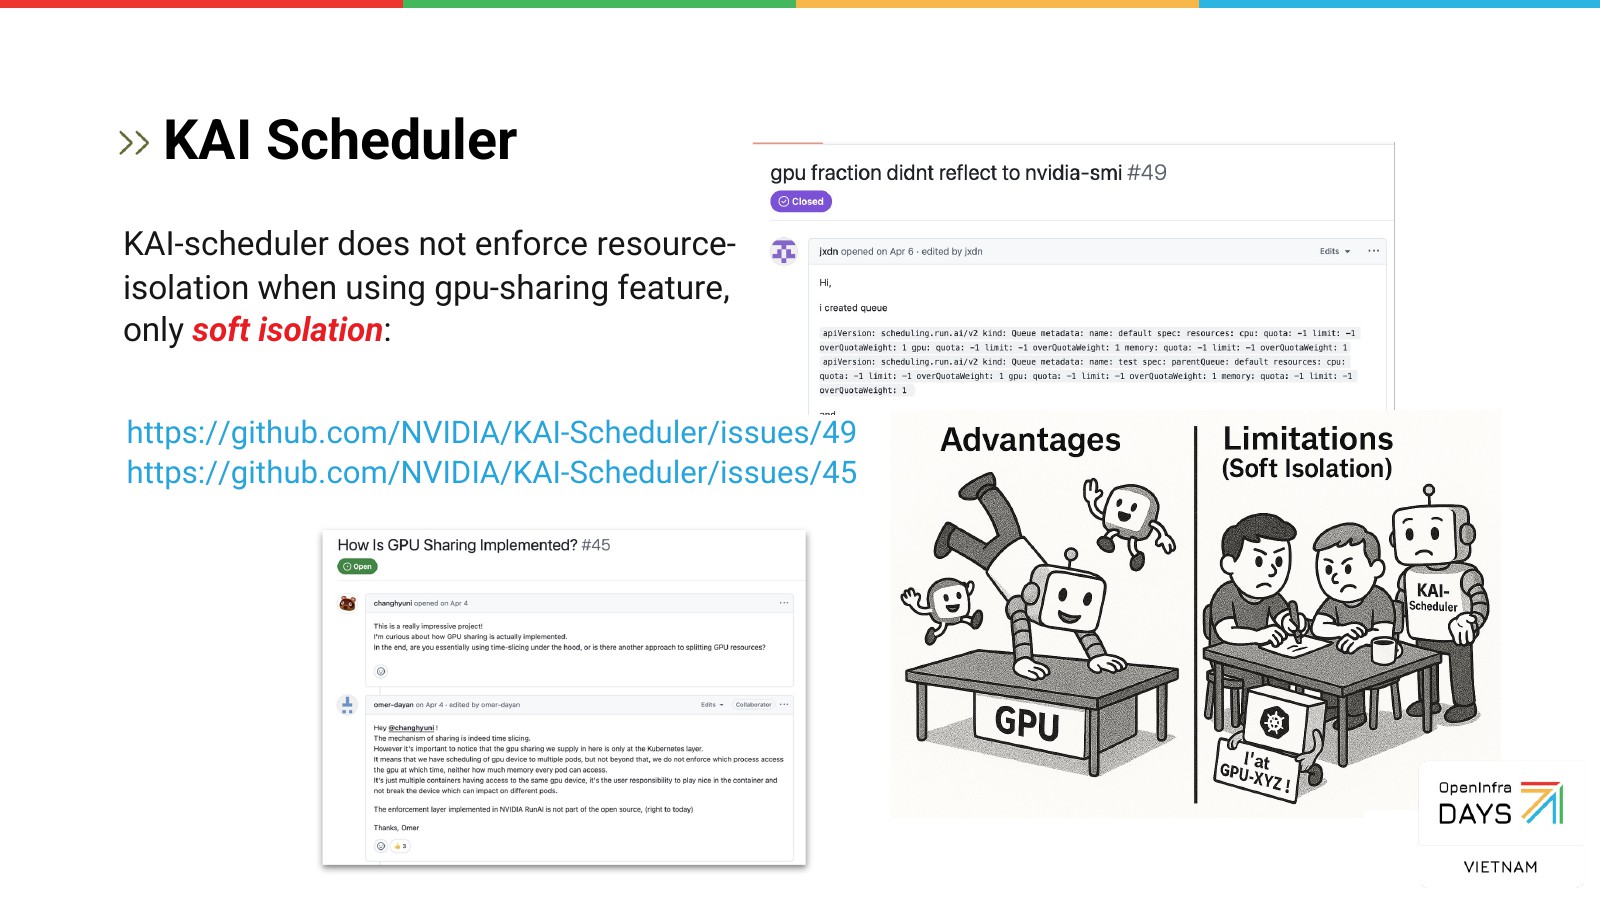
Soft isolation không sai. Nó giữ cho scheduler đơn giản và không chen vào đường đi của CUDA. Nhưng nó cũng có nghĩa là pod này có thể lấn sang phần memory đã hứa cho pod bên cạnh. Với một nền tảng dùng chung mà người dùng không quen biết nhau thì bọn mình muốn giới hạn phải cứng.
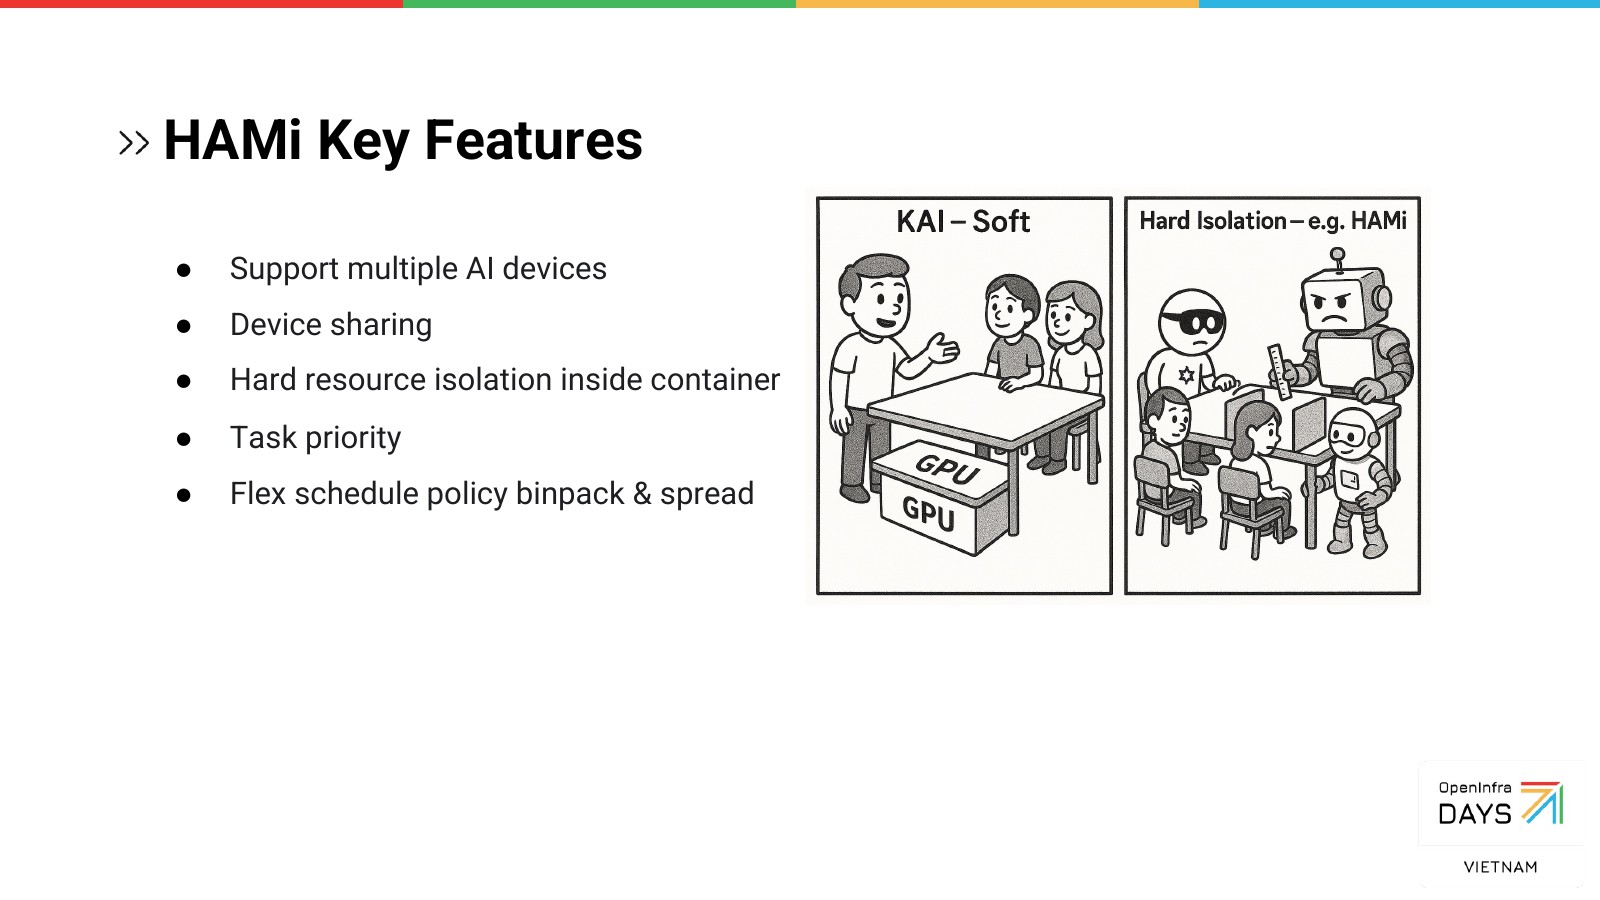
HAMi ép một phần GPU như thế nào
HAMi lúc đó là dự án CNCF Sandbox. Phần mới của talk này là đi theo một pod xuyên qua nó, gồm bốn mảnh.
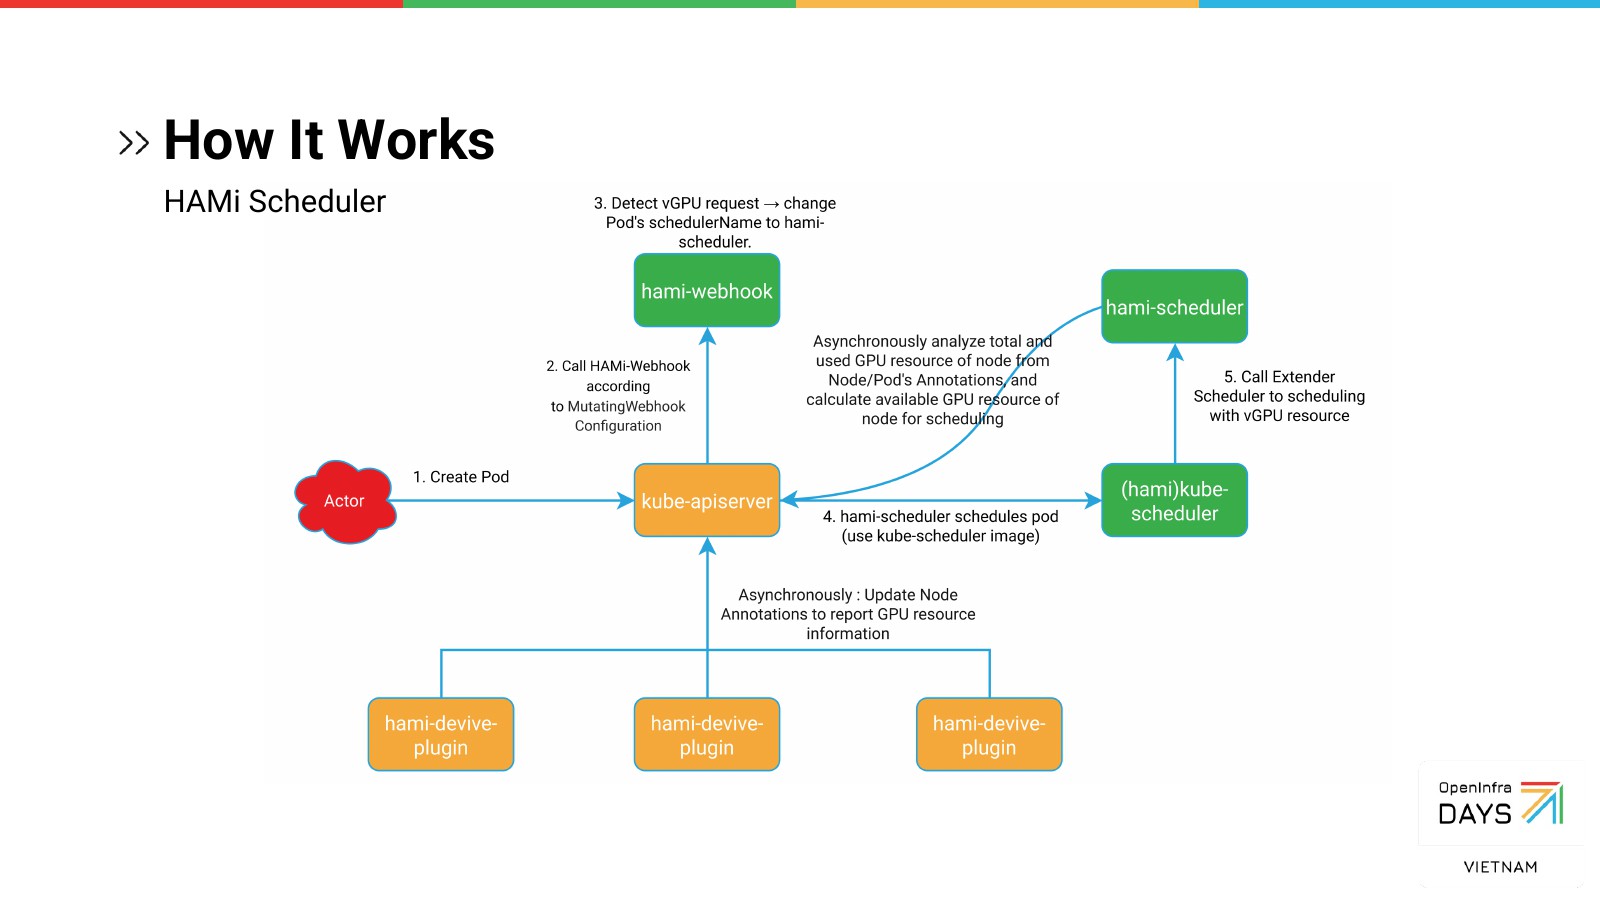
Webhook và scheduler. Bạn tạo một pod xin vGPU. Mutating webhook nhận ra request đó và đổi
schedulerName của pod sang HAMi scheduler. Scheduler này là kube-scheduler có thêm extender của HAMi: nó
đọc mức dùng GPU mà mỗi node báo qua annotation, tính phần còn trống, rồi chọn node và thiết bị.
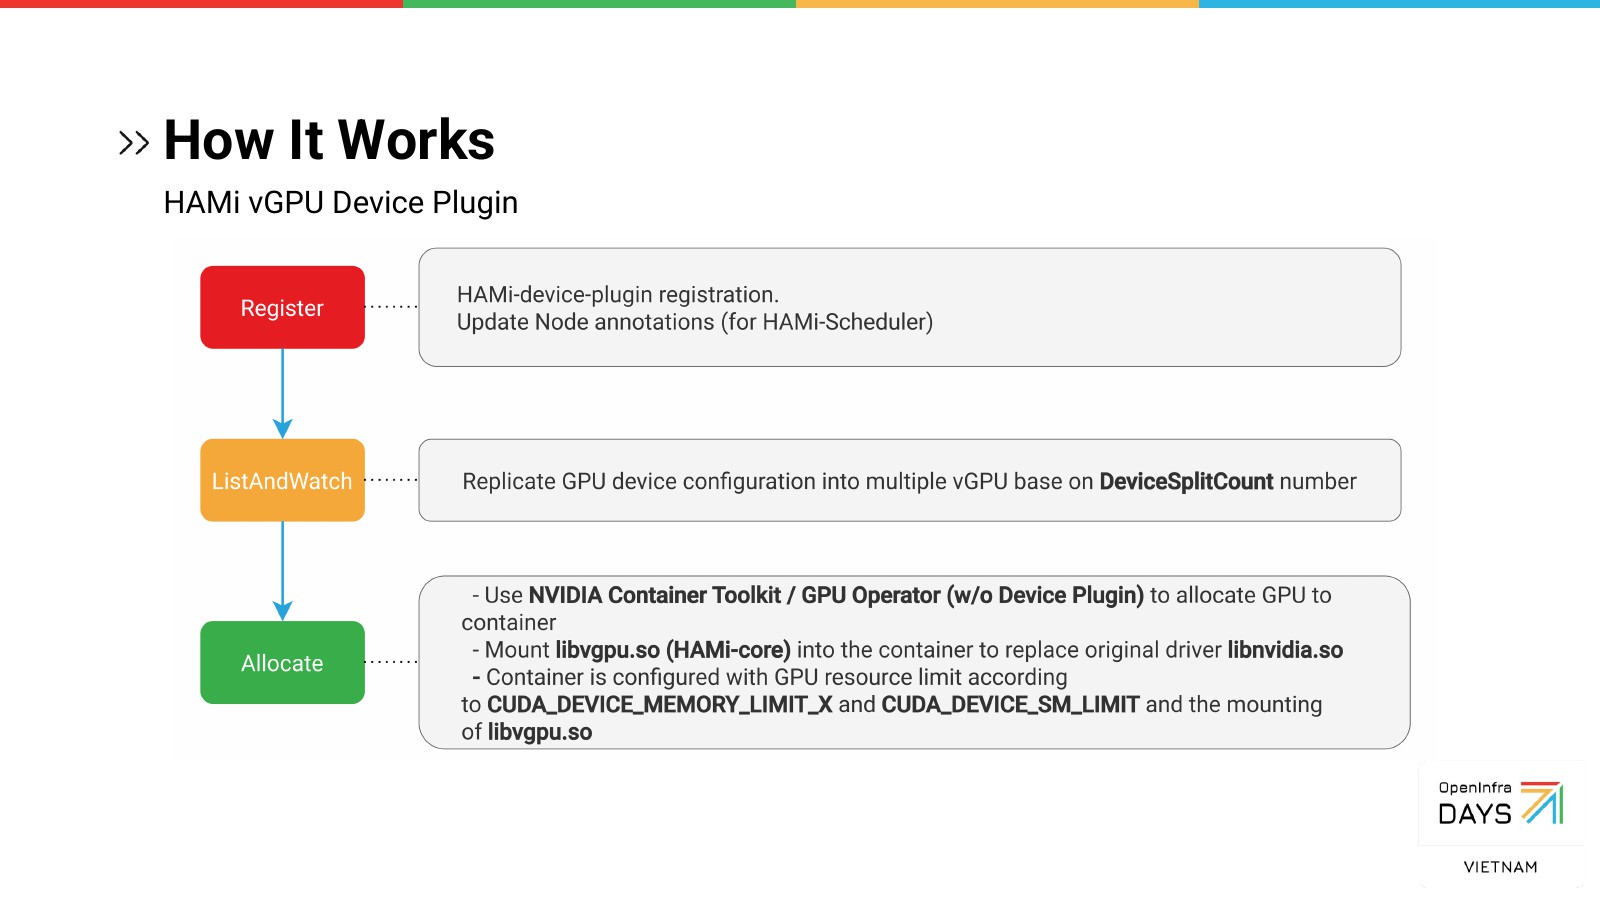
Device plugin. Trên mỗi node, HAMi device plugin đăng ký và cập nhật annotation của node. Ở bước
ListAndWatch, nó quảng bá mỗi GPU vật lý thành nhiều vGPU theo DeviceSplitCount. Ở bước Allocate, nó
dùng NVIDIA Container Toolkit (GPU Operator nhưng tắt device plugin riêng) để cấp GPU cho container, mount
libvgpu.so, và đặt các giới hạn qua biến môi trường.
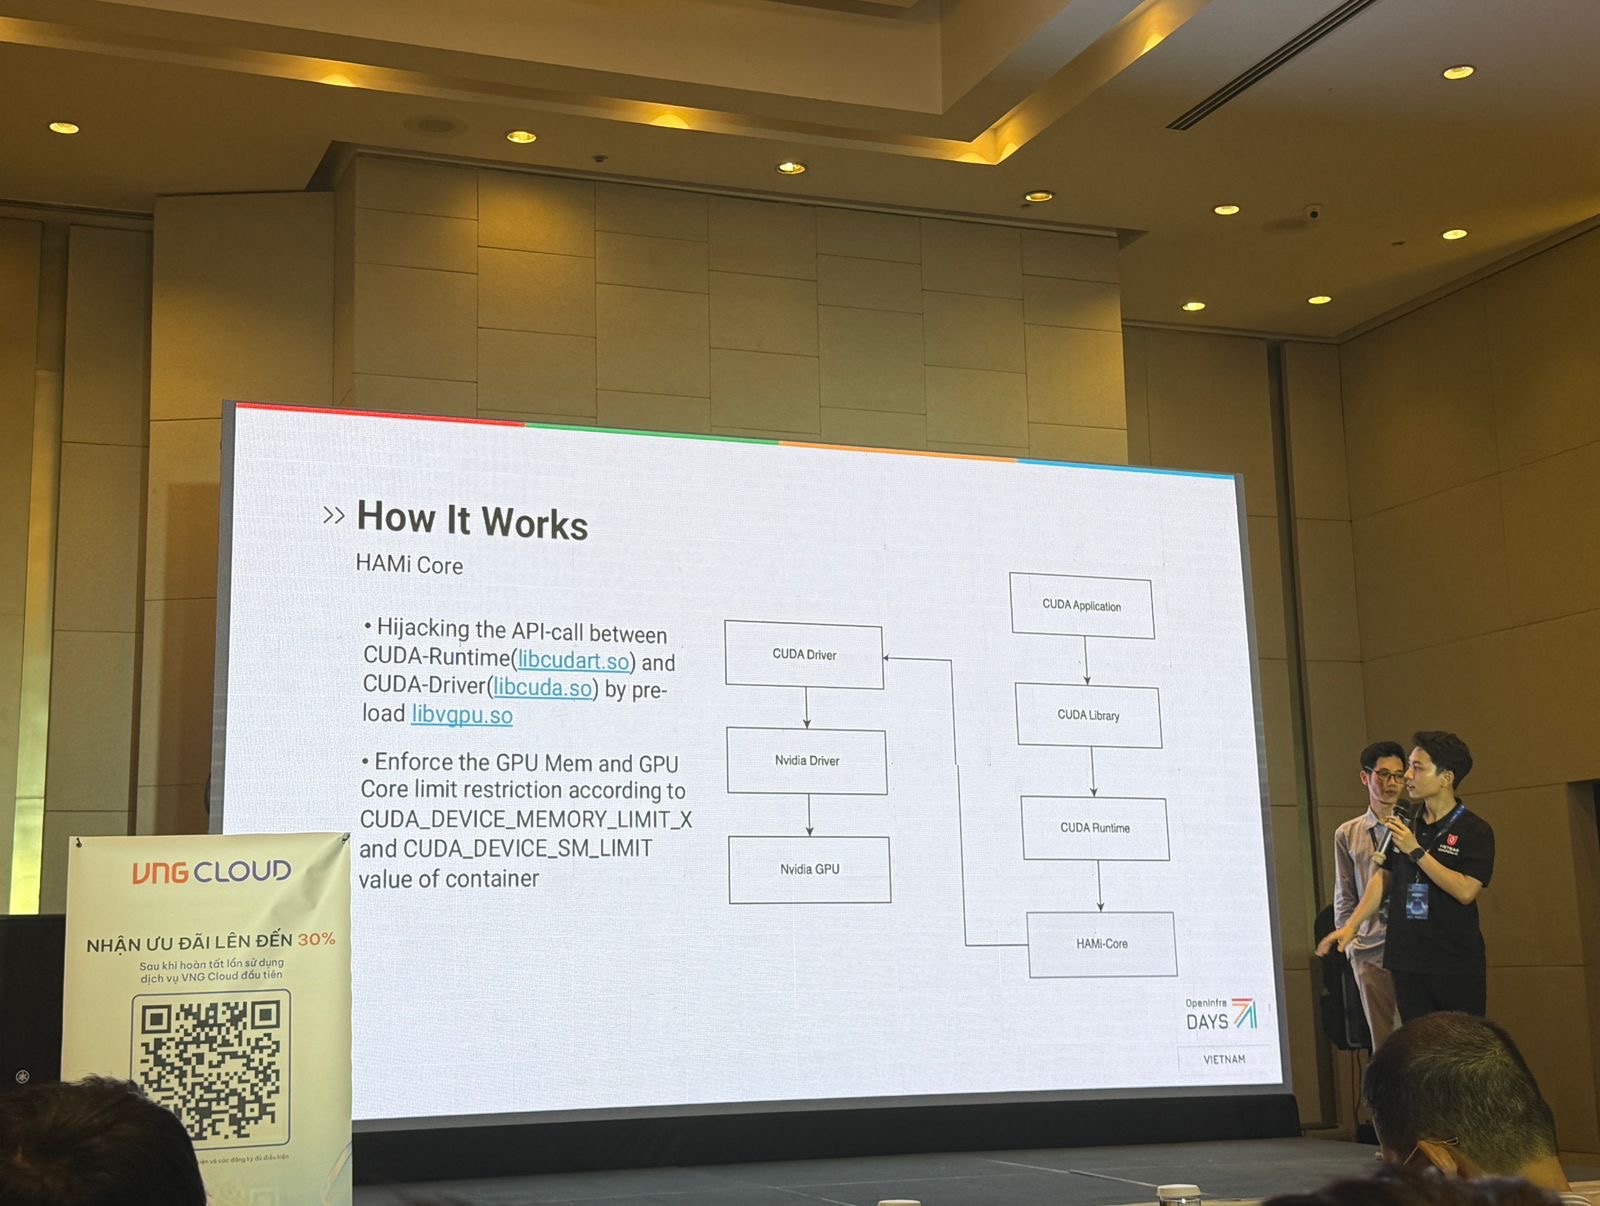
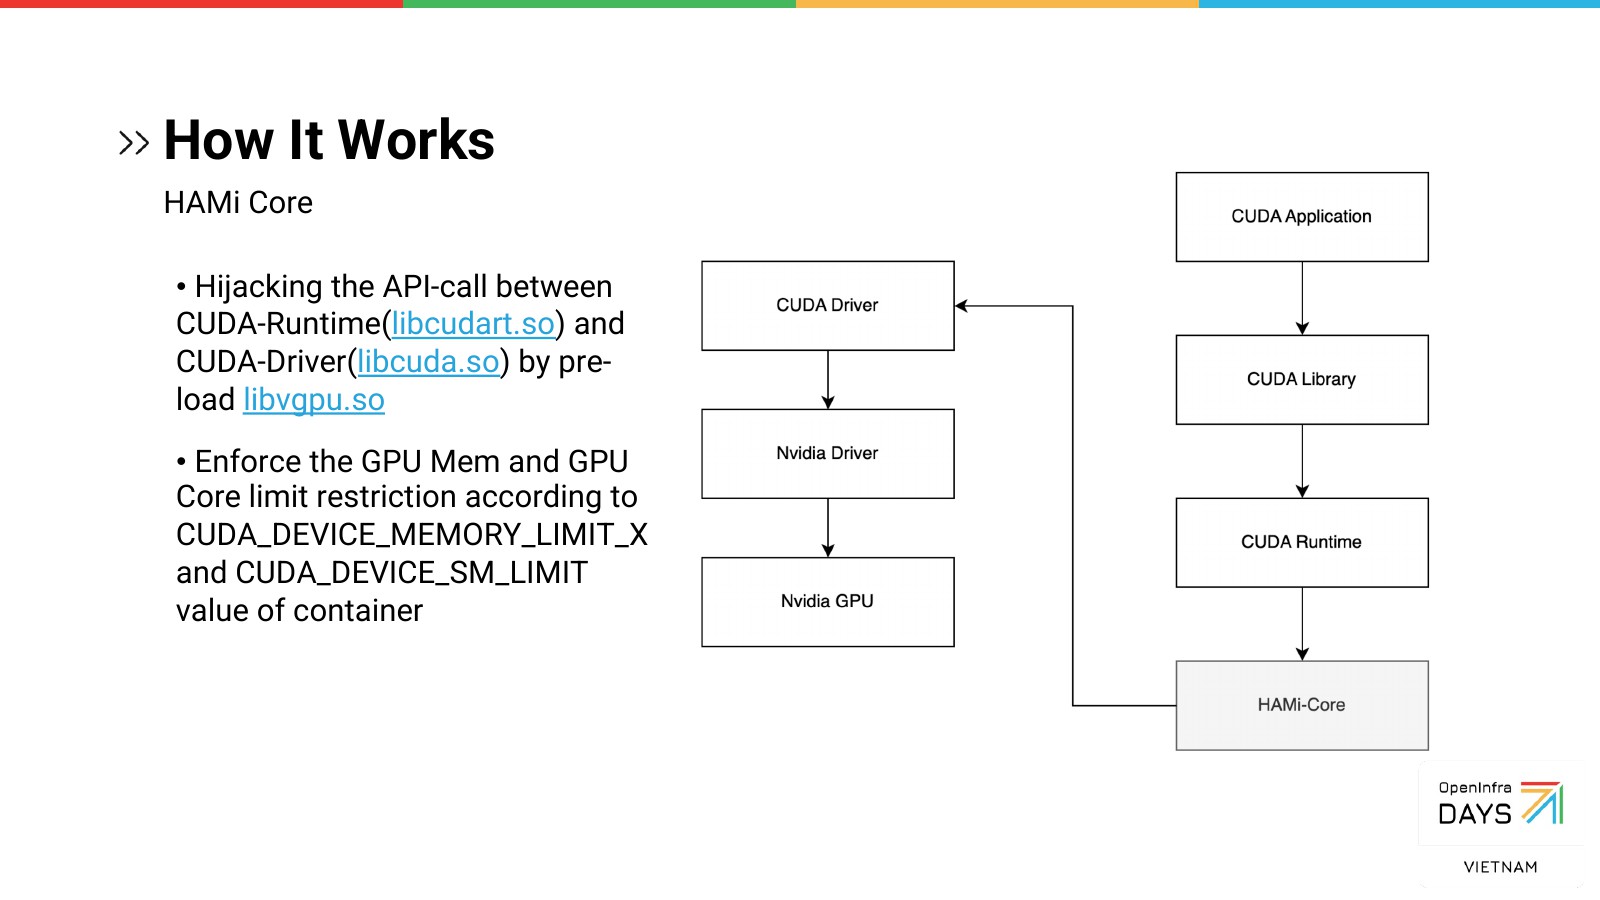
HAMi Core. Đây là chỗ giới hạn trở nên cứng. libvgpu.so được preload vào container và nằm giữa CUDA
runtime (libcudart.so) với CUDA driver (libcuda.so). Mọi lời gọi đều đi qua nó, và nó ép giới hạn memory
và core theo CUDA_DEVICE_MEMORY_LIMIT_X và CUDA_DEVICE_SM_LIMIT.
Tháng 5 bọn mình chỉ cho xem một tham số là gpumem. Lần này là toàn bộ những gì pod có thể xin:
resources:
  limits:
    nvidia.com/gpu: 1                  # một vGPU
    nvidia.com/gpumem: 3000            # 3000 MB device memory
    nvidia.com/gpucores: 50            # 50% core của thiết bị
    # nvidia.com/gpumem-percentage: 50 # hoặc memory theo phần trăm card
    # nvidia.com/use-gputype: "A100,V100"    # chỉ các loại card này
    # nvidia.com/nouse-gputype: "1080,2080"  # không bao giờ dùng các loại này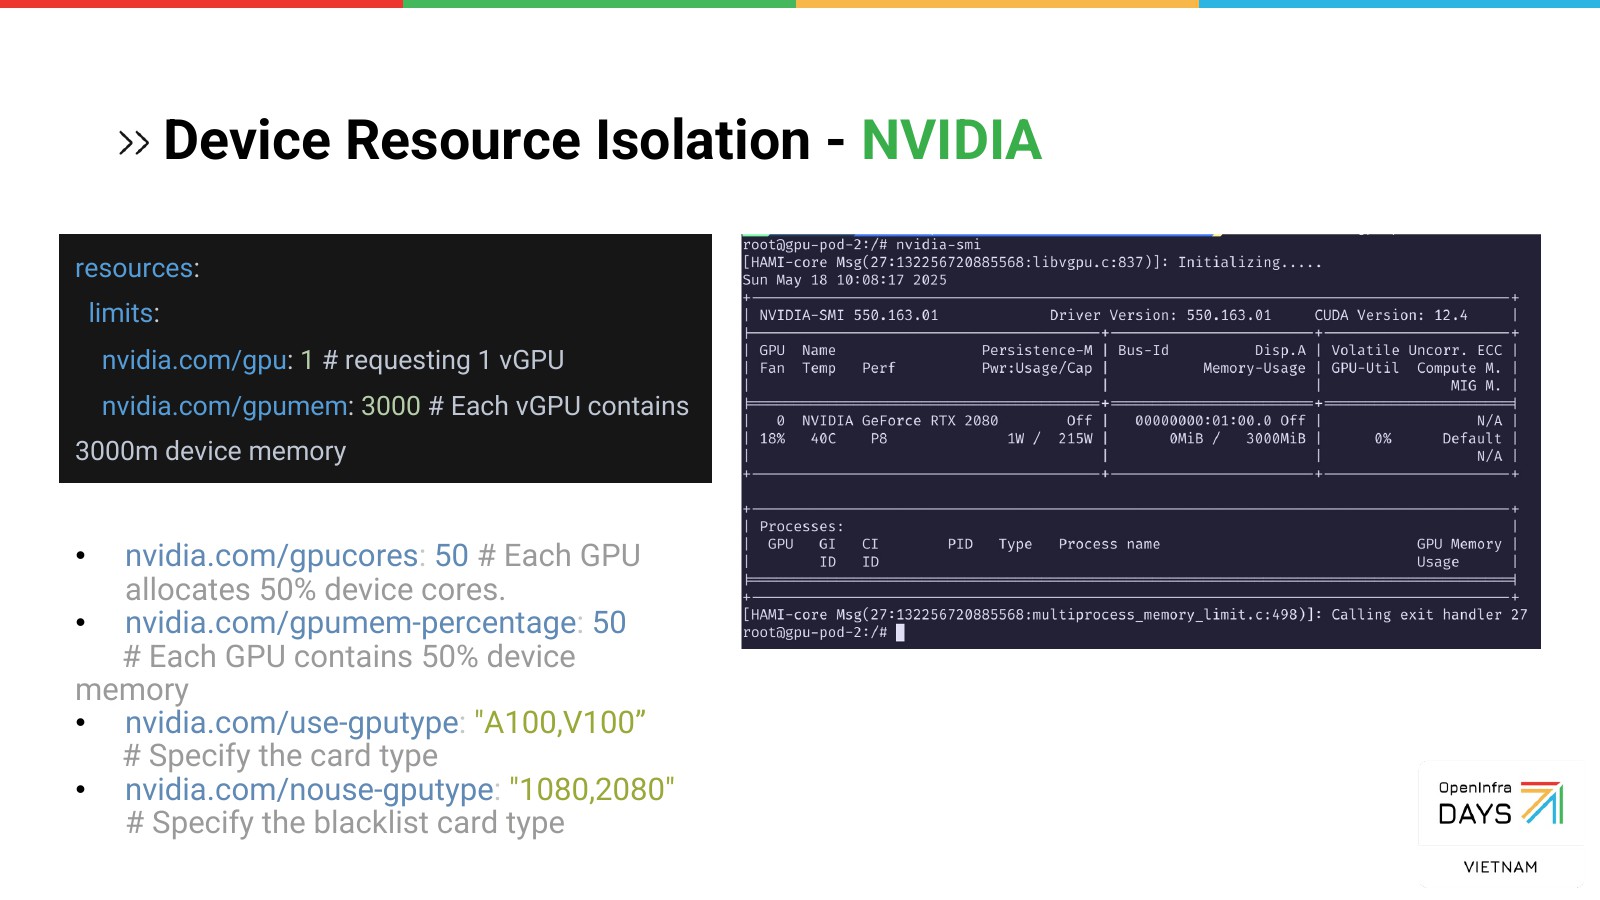
Fractional GPU trong Kubeflow Notebooks
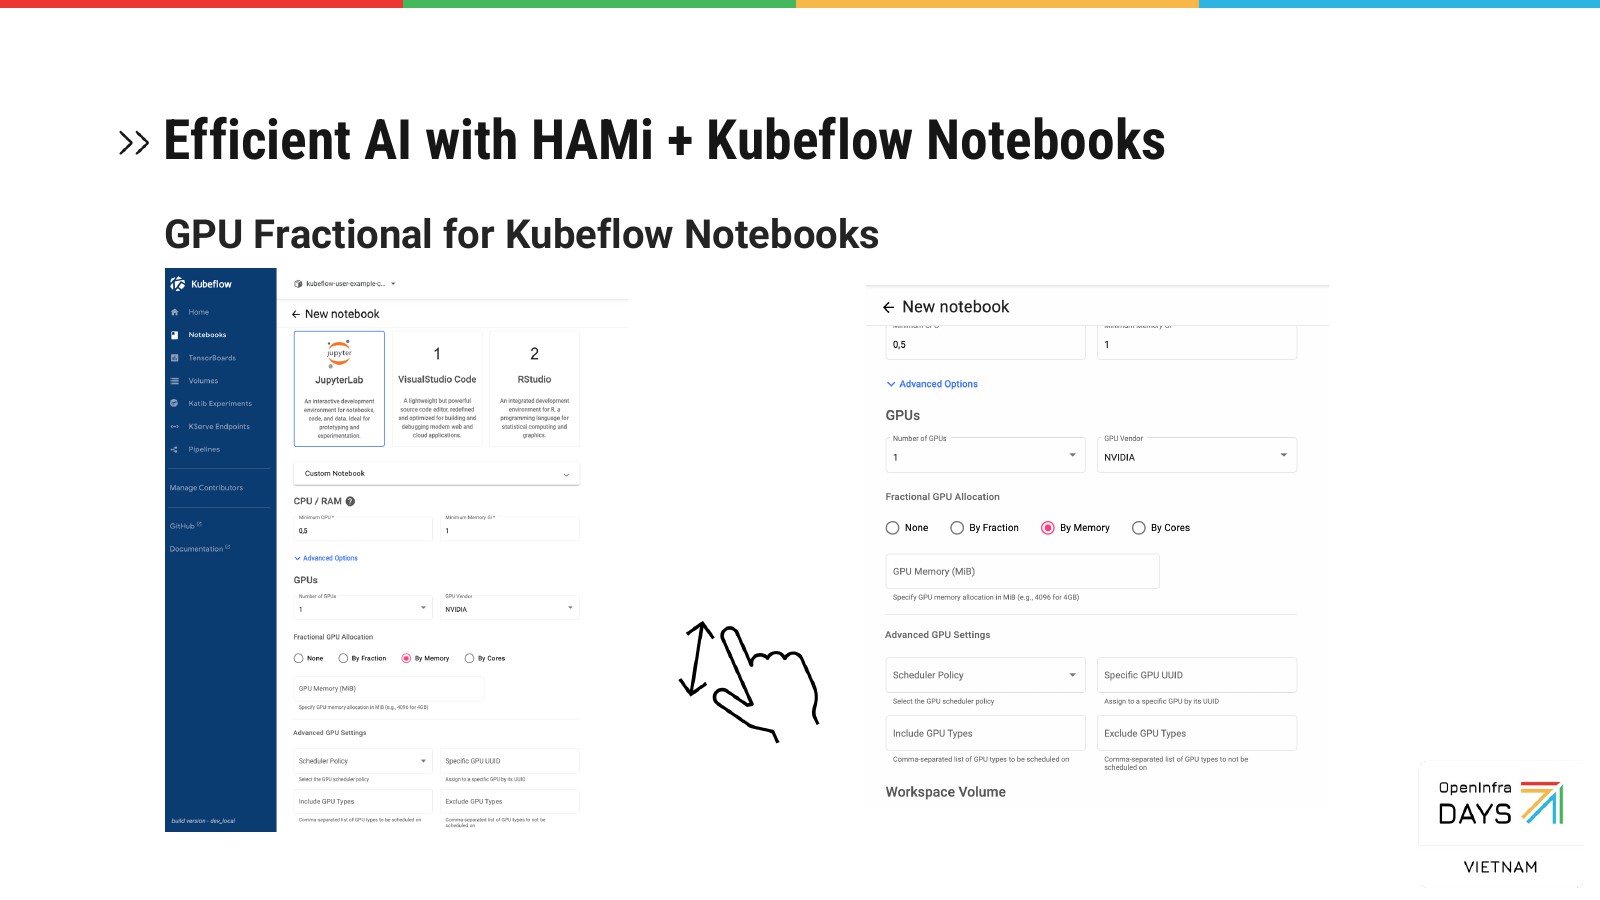
Khi phát triển model bằng notebook thì GPU không bận liên tục: bạn chạy một cell, đọc kết quả, sửa code. Vì thế notebook là chỗ tự nhiên để nhiều người dùng chung một card.
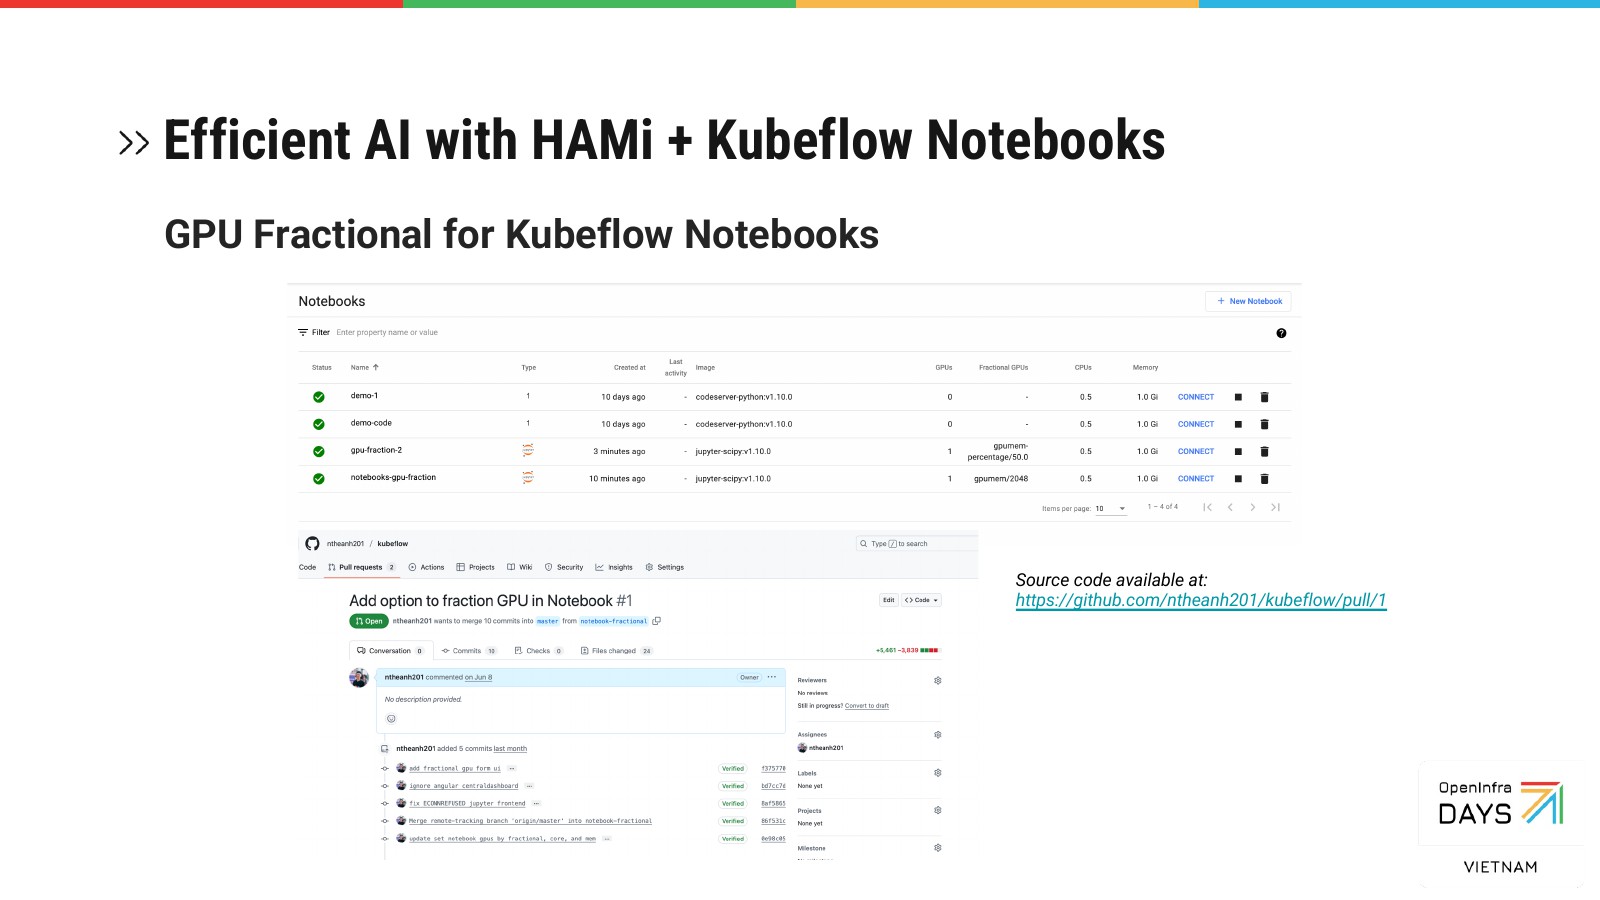
Nên bọn mình thêm tuỳ chọn fractional GPU vào form tạo notebook của Kubeflow. Khi tạo notebook, bạn chọn cách chia GPU: theo fraction, theo memory hoặc theo core. Bạn cũng có thể đặt scheduling policy, chỉ định GPU UUID cụ thể, và chọn loại card được dùng hoặc không được dùng. Notebook sau đó chạy thành một pod với giới hạn HAMi tương ứng. Thay đổi này nằm trong một pull request trên fork Kubeflow của mình.
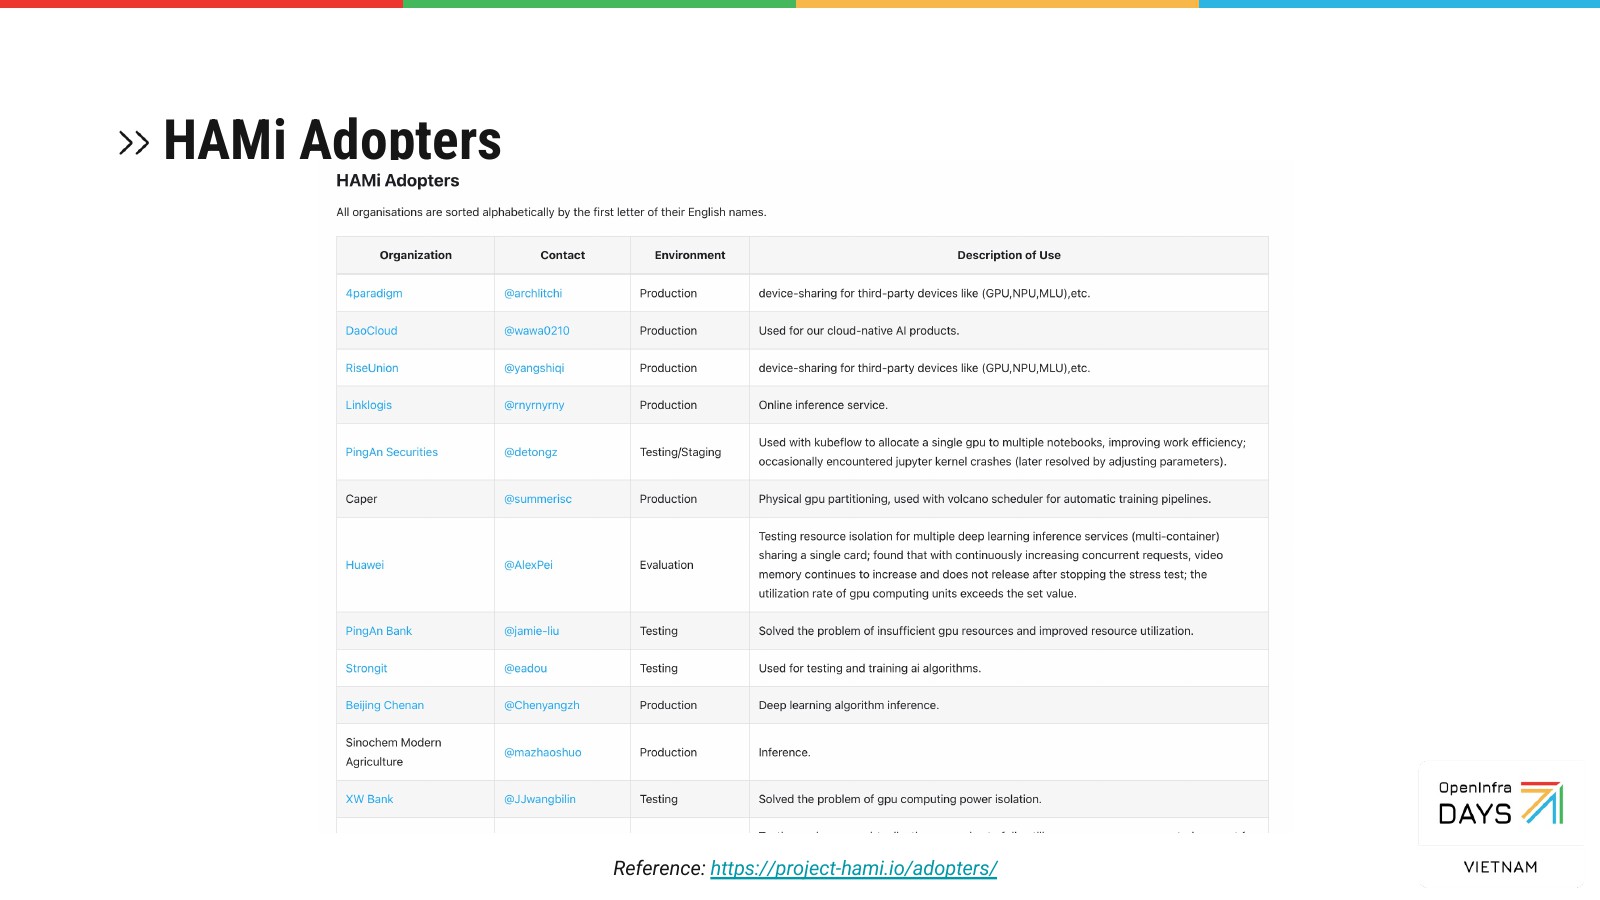
Bọn mình kết thúc bằng danh sách adopter của HAMi, để mọi người thấy ai đang dùng nó.
Chuyện tiếp theo
Talk này nói về cơ chế. Câu hỏi còn bỏ ngỏ là số liệu có trụ được trong production hay không. Một năm sau, ở KCD & OpenInfra Days Vietnam 2026, bọn mình trả lời bằng workload thật: gấp 3,4 lần khối lượng việc trên mỗi GPU, cần những gì để vận hành, và job nào không được lợi (recap bài nói ở KCD).
Cảm ơn VietOpenInfra và ban tổ chức OpenInfra & Cloud Native Day Vietnam 2025. Nếu bạn đã chạy HAMi hay một lớp chia sẻ GPU khác và vạch ranh giới giữa soft và hard isolation ở chỗ khác, mình rất muốn nghe bạn đặt ở đâu.