Recap Cloud Native Hanoi May Meetup: Fractional GPU for AI, giải pháp mã nguồn mở trong Cloud Native
Kubernetes cấp GPU theo nguyên card. Bọn mình so sánh ba cách mã nguồn mở để chia nhỏ GPU, và thấy rằng xếp lịch cho một phần GPU thì dễ, còn ép được giới hạn đó mới là phần khó.
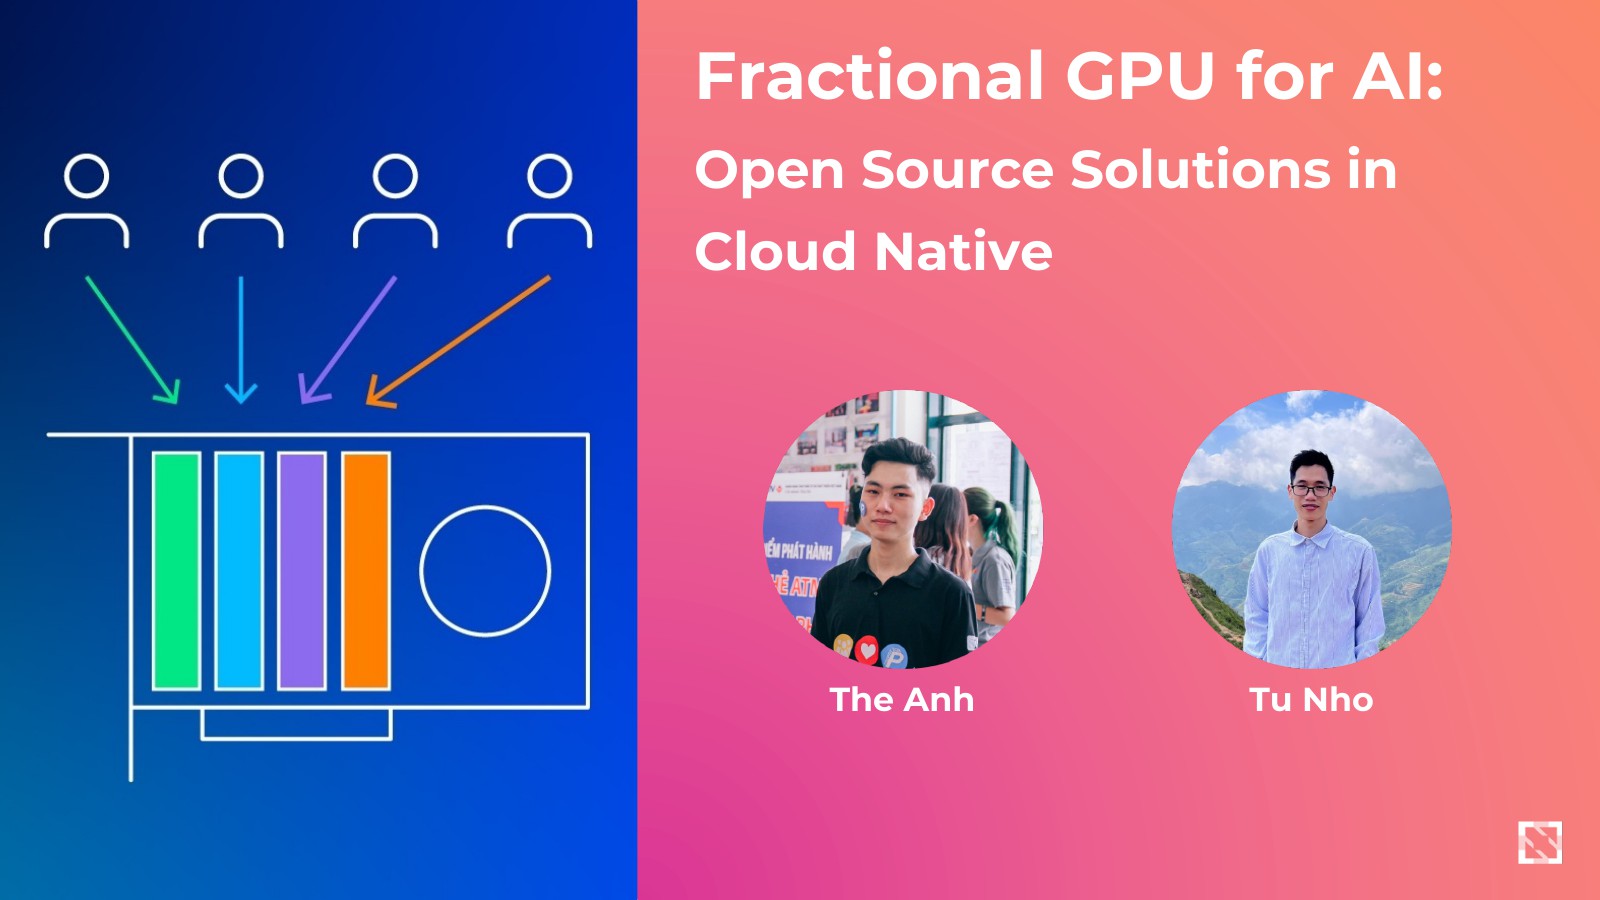
Kubernetes coi GPU là một thứ không chia được: pod xin nvidia.com/gpu: 1 là nhận nguyên card, kể cả khi
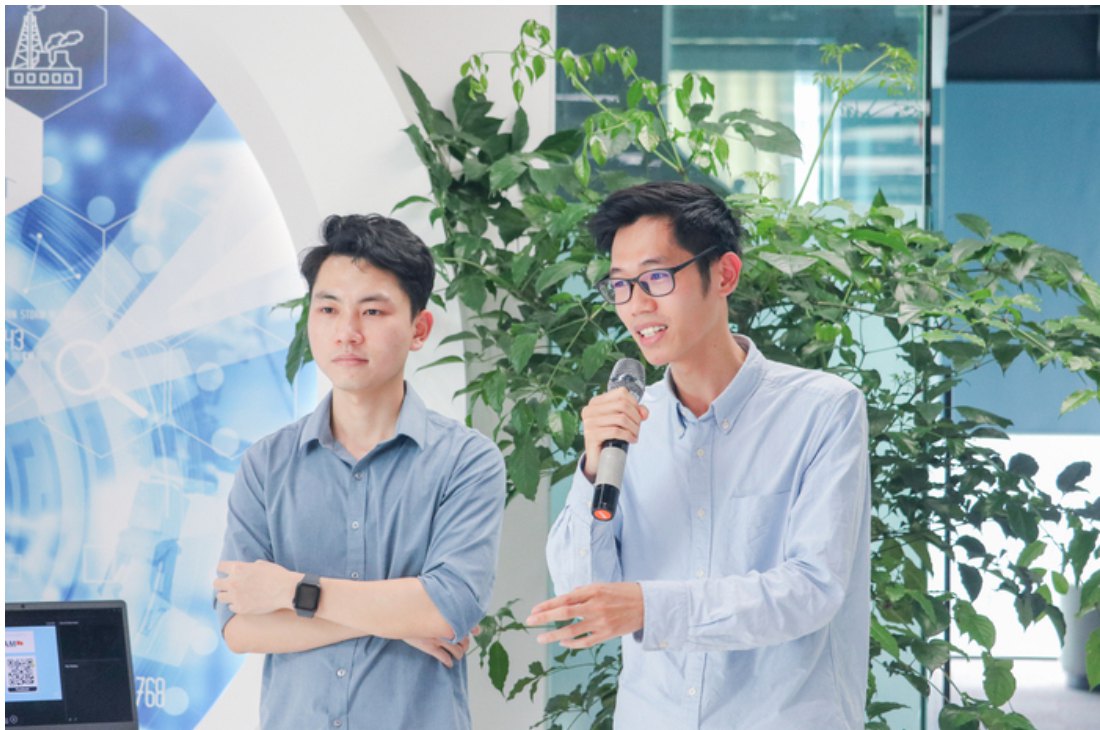
nó chỉ cần một phần mười. Mình và anh Nho Minh Tú, cùng team, đã so sánh các cách mã nguồn mở để vượt qua giới
hạn đó, rồi chia sẻ lại ở Cloud Native Hanoi May Meetup “GPU and eBPF on Kubernetes” ngày 25/5/2025.
Nói ngắn gọn thì cho nhiều pod chạy chung một GPU khá dễ, còn bảo đảm mỗi pod chỉ dùng đúng phần nó xin mới là phần khó, và các lựa chọn bọn mình thử khác nhau chính ở chỗ đó.
Fractional GPU là gì
Fractional GPU là chia tài nguyên của một GPU thành nhiều phần nhỏ để nhiều pod chạy cùng lúc trên một card. Bản thân NVIDIA đã có vài cách chia sẻ GPU, mỗi cách nằm ở một tầng khác nhau:
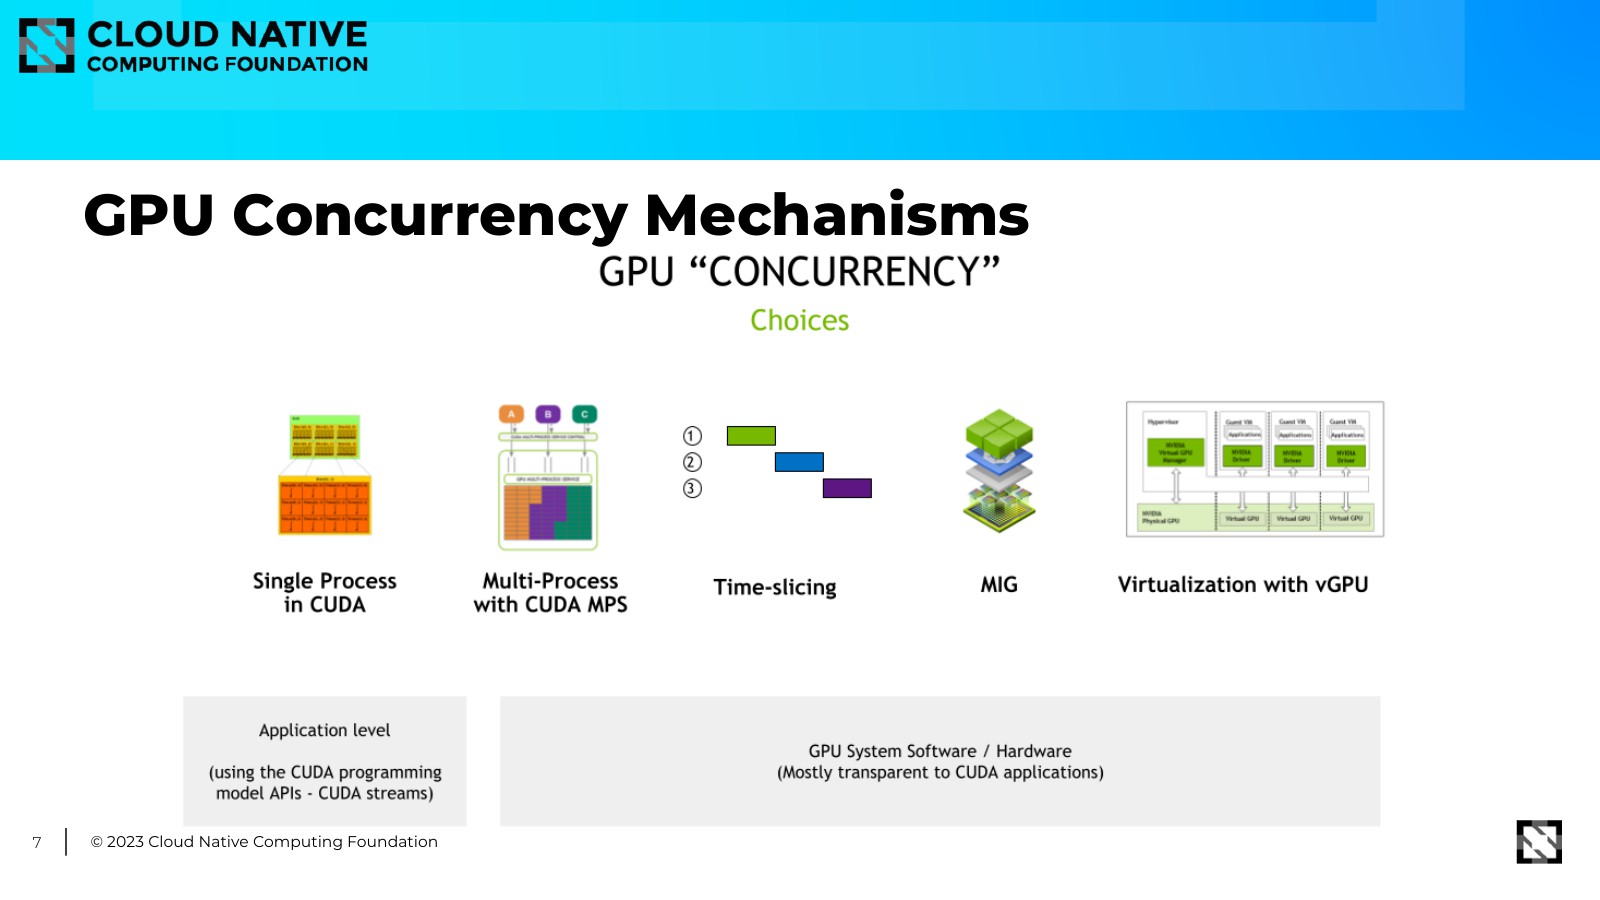
- Single process với CUDA streams, ngay trong một ứng dụng.
- Multi-Process Service (MPS), nhiều process dùng chung một context.
- Time-slicing, các process lần lượt dùng cả GPU.
- MIG, chia phân vùng ở phần cứng trên những card hỗ trợ.
- vGPU, ảo hoá ở tầng dưới hệ điều hành.
Câu hỏi của cloud native là làm sao xin và xếp lịch các phần đó từ Kubernetes, rồi giám sát và quản lý chúng khi đã chạy.
Cách 1: KAI Scheduler chia được nhưng không cô lập
KAI Scheduler là scheduler GPU native cho Kubernetes, tách ra từ nền tảng Run:ai. Nó hỗ trợ GPU sharing theo hai kiểu: pod xin một phần GPU (fraction), hoặc xin một lượng GPU memory, rồi nhiều pod được xếp chung lên một thiết bị.
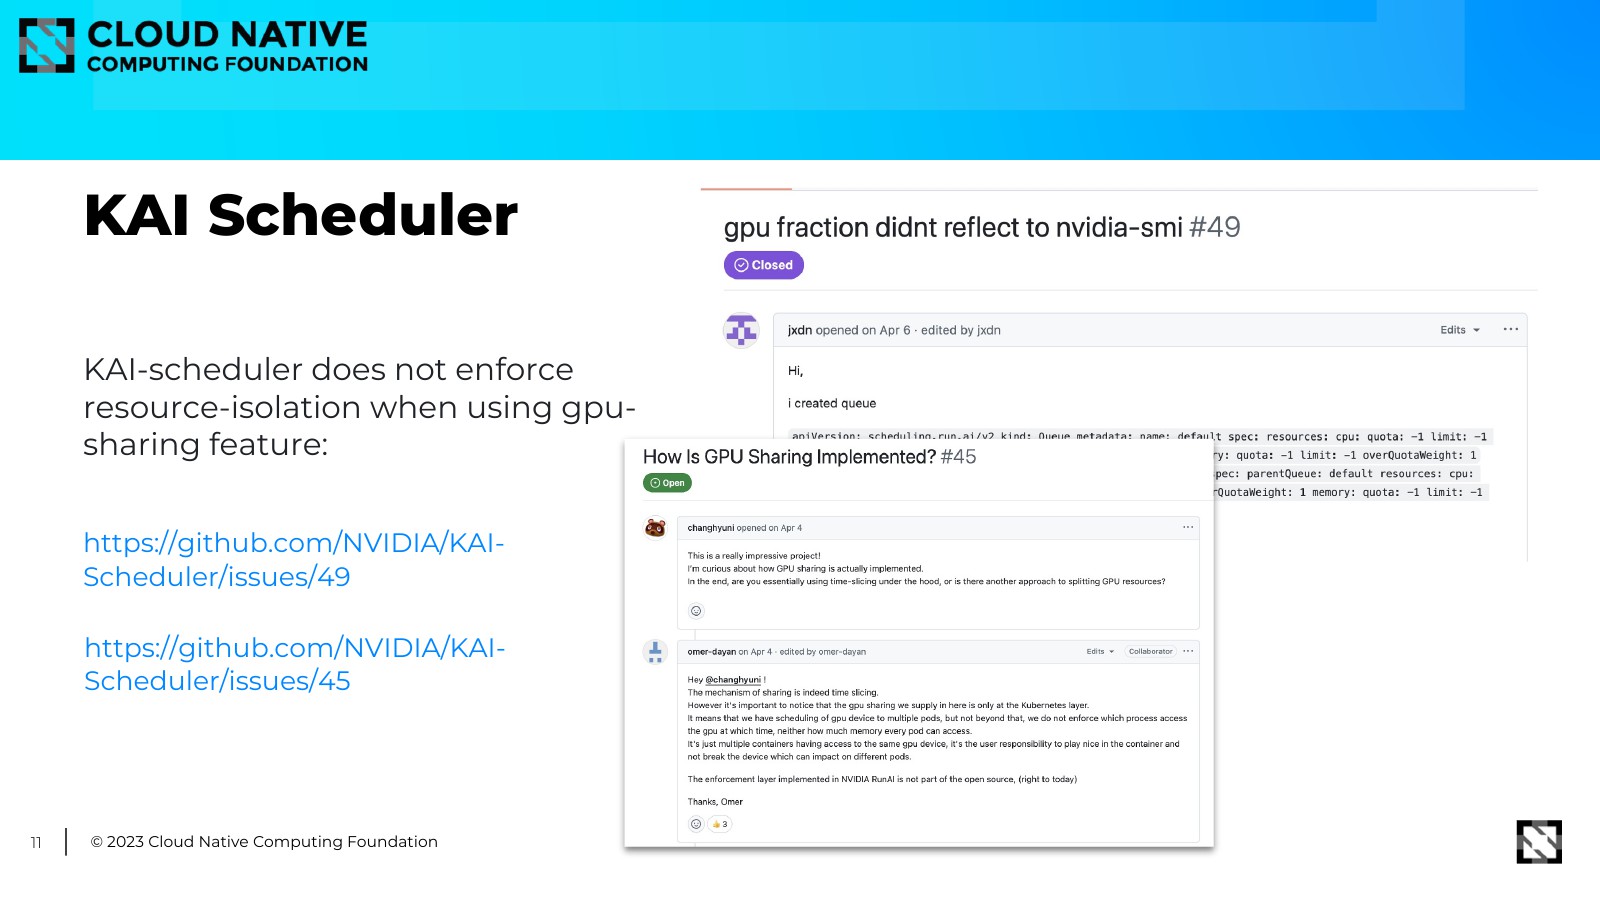
Có điều nó không ép giới hạn đó. Xin một phần GPU rồi chạy nvidia-smi trong pod thì vẫn thấy nguyên card.
Hai issue trên repo mô tả đúng chuyện này:
gpu fraction didn’t reflect to nvidia-smi và
how is GPU sharing implemented?. Câu trả lời là
scheduler chỉ xếp pod theo phần chúng xin, còn việc ở trong phần của mình là trách nhiệm của từng workload.
Lúc đó KAI cũng vừa nộp đơn vào CNCF Sandbox, nên bọn mình để một slide với dấu hỏi: KAI to CNCF?
Cách 2: mượn phần cô lập của ClearML
Fractional GPU của ClearML đi theo hướng ngược lại.
Lựa chọn mã nguồn mở của họ là một bộ container đóng gói sẵn, có giới hạn memory cứng ngay trong image:
clearml/fractional-gpu:u22-cu12.3-2gb, -4gb, -8gb, v.v. Giới hạn nằm ở image chứ không nằm ở
scheduler.
Vì thế bọn mình đề xuất ghép hai thứ lại: KAI quyết định pod chạy ở đâu, còn container ClearML giữ cho pod không vượt quá phần memory của nó. Trên một node có một card 8 GB, pod cần 2 GB sẽ xin KAI 2000 MiB memory (hoặc fraction 0,25) và chạy image ClearML 2 GB.
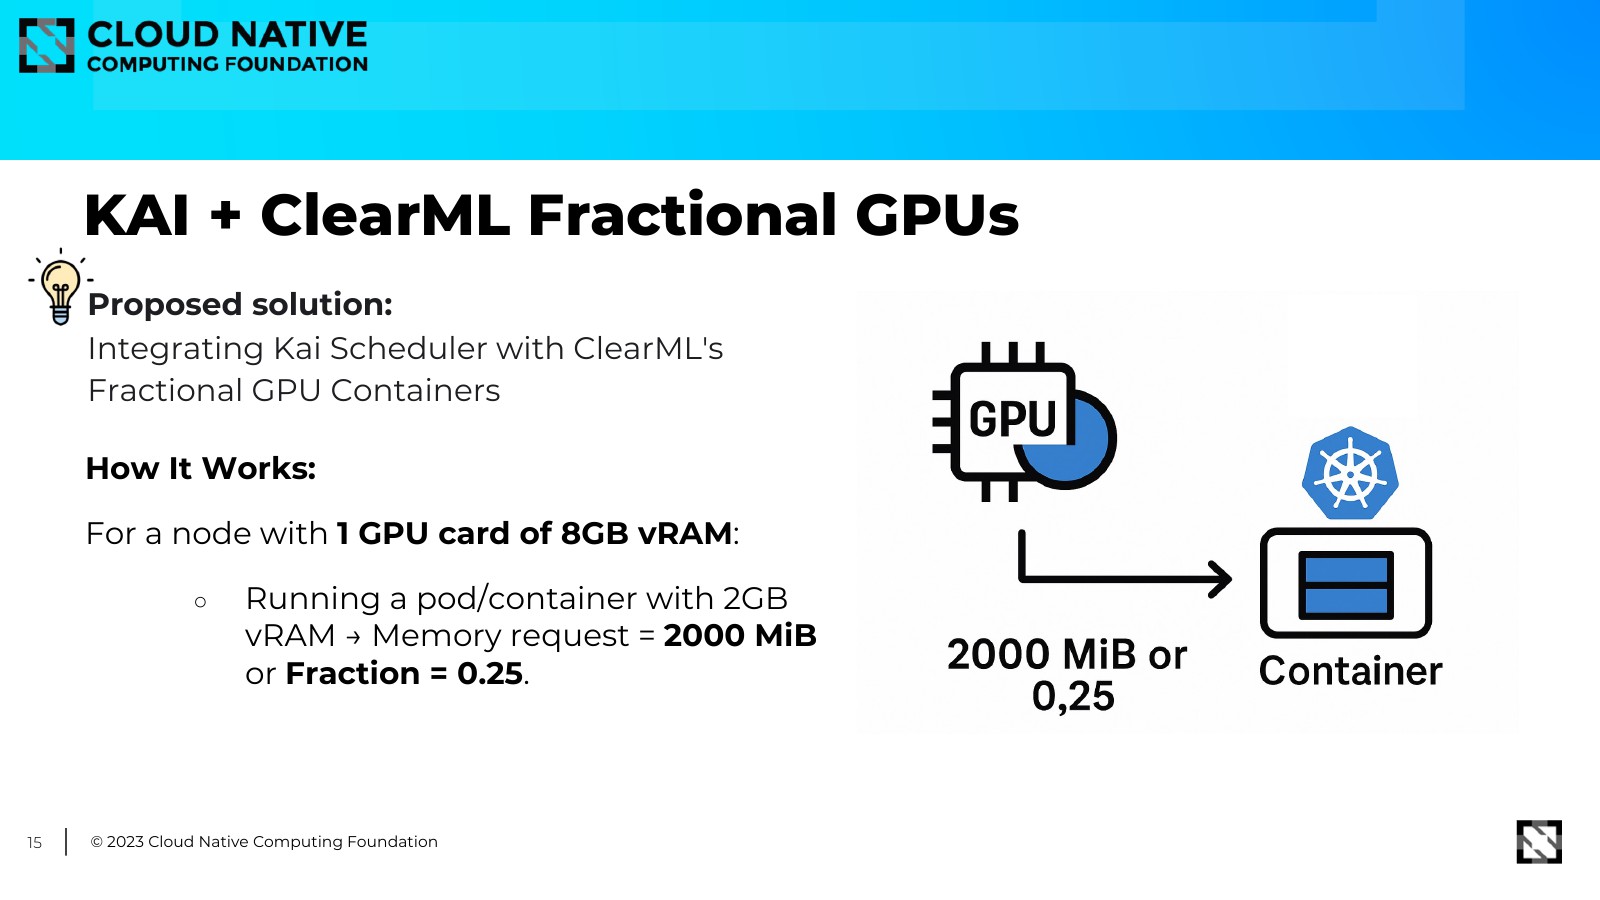
Trên lý thuyết thì cách này lấp được khoảng trống, nhưng thực tế là hai công cụ dán vào nhau, mà giới hạn lại phụ thuộc vào image bạn chọn.
Cách 3: HAMi
HAMi (Heterogeneous AI Computing Virtualization Middleware) lúc đó là một dự án CNCF Sandbox. Nó quản lý nhiều loại thiết bị AI khác nhau trong cùng một cụm Kubernetes, NVIDIA lẫn các hãng khác như Huawei Ascend, và tự lo cả việc chia sẻ lẫn cô lập.
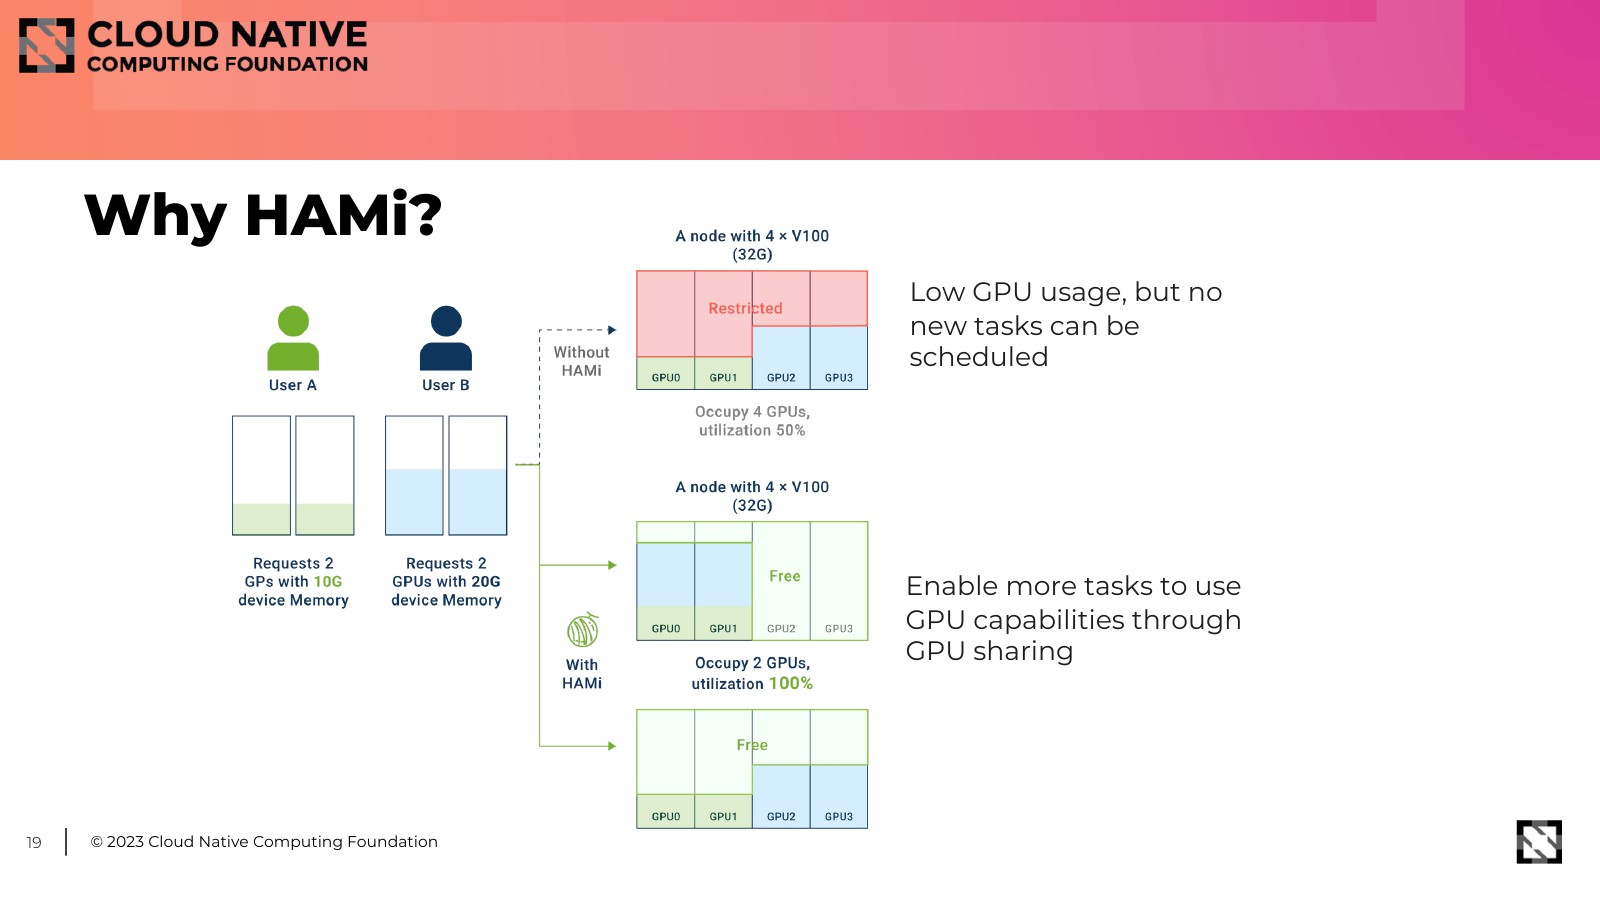
Bài toán nó giải đúng là bài toán bọn mình gặp: GPU dùng rất ít, nhưng task mới vẫn không xếp lịch được vì card nào cũng đang bị giữ nguyên. Danh sách tính năng của HAMi cũng khớp với thứ bọn mình cần: hỗ trợ nhiều loại thiết bị AI, chia sẻ thiết bị, cô lập tài nguyên cứng bên trong container, độ ưu tiên task, và chính sách xếp lịch binpack hoặc spread.
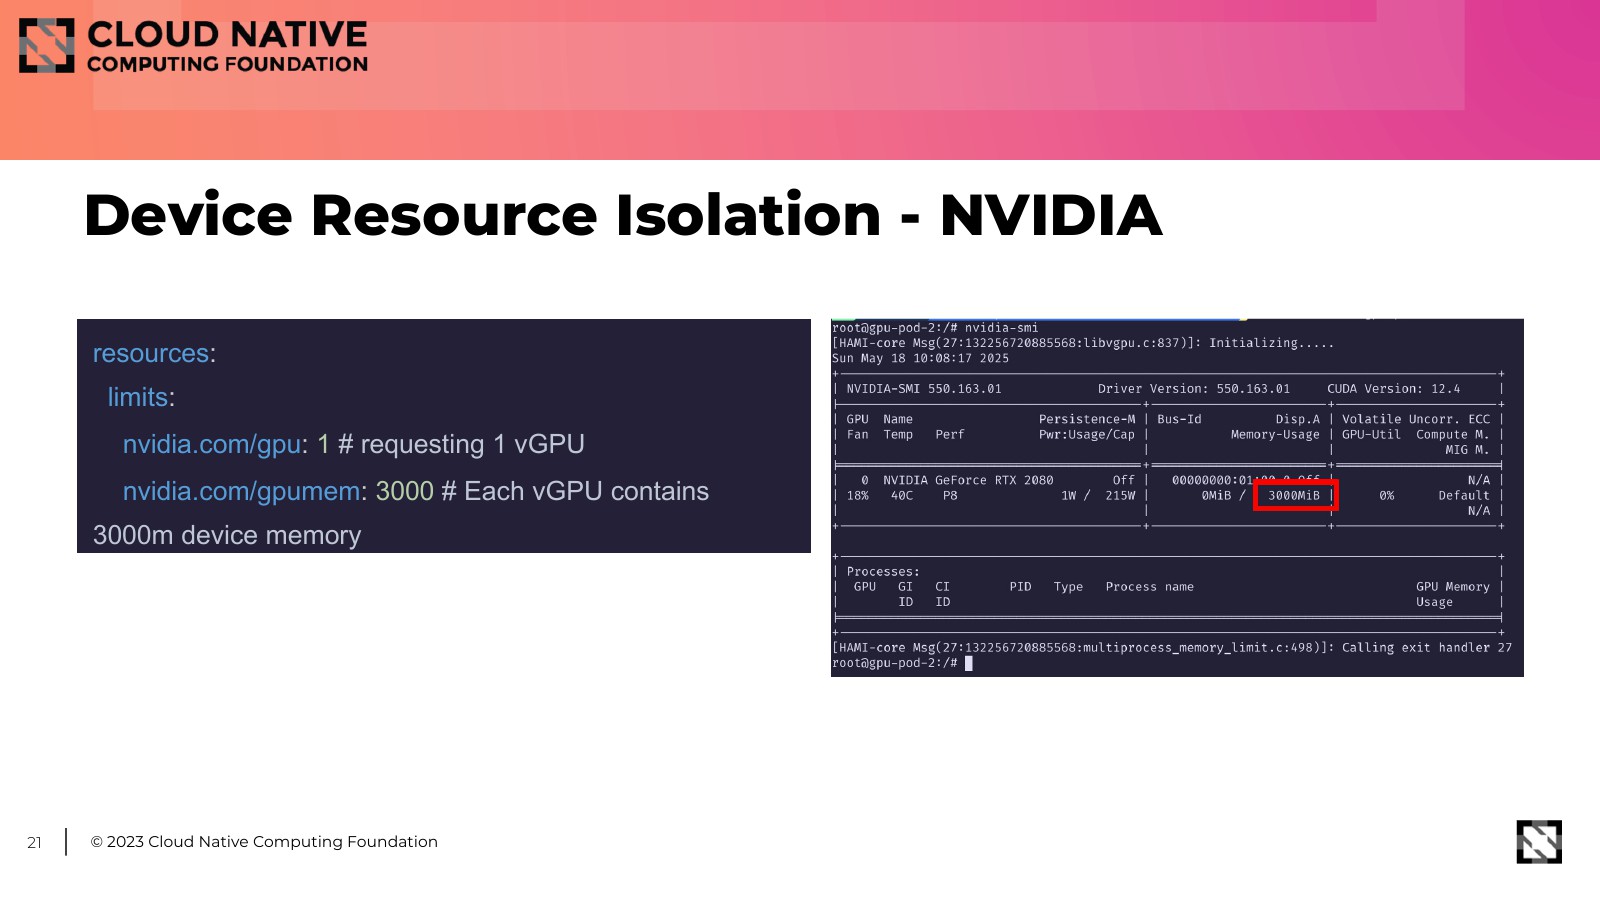
Phần cô lập là phần bọn mình cho mọi người xem trực tiếp. Một pod xin một vGPU với 3000 MB memory:
resources:
  limits:
    nvidia.com/gpu: 1        # xin 1 vGPU
    nvidia.com/gpumem: 3000  # mỗi vGPU có 3000 MB device memory
Trong pod, nvidia-smi trên card RTX 2080 chỉ hiện 3000 MiB chứ không phải nguyên card. Đó là điểm khác với
hai cách trước: giới hạn được ép ngay bên trong container, dù bạn chạy image nào.
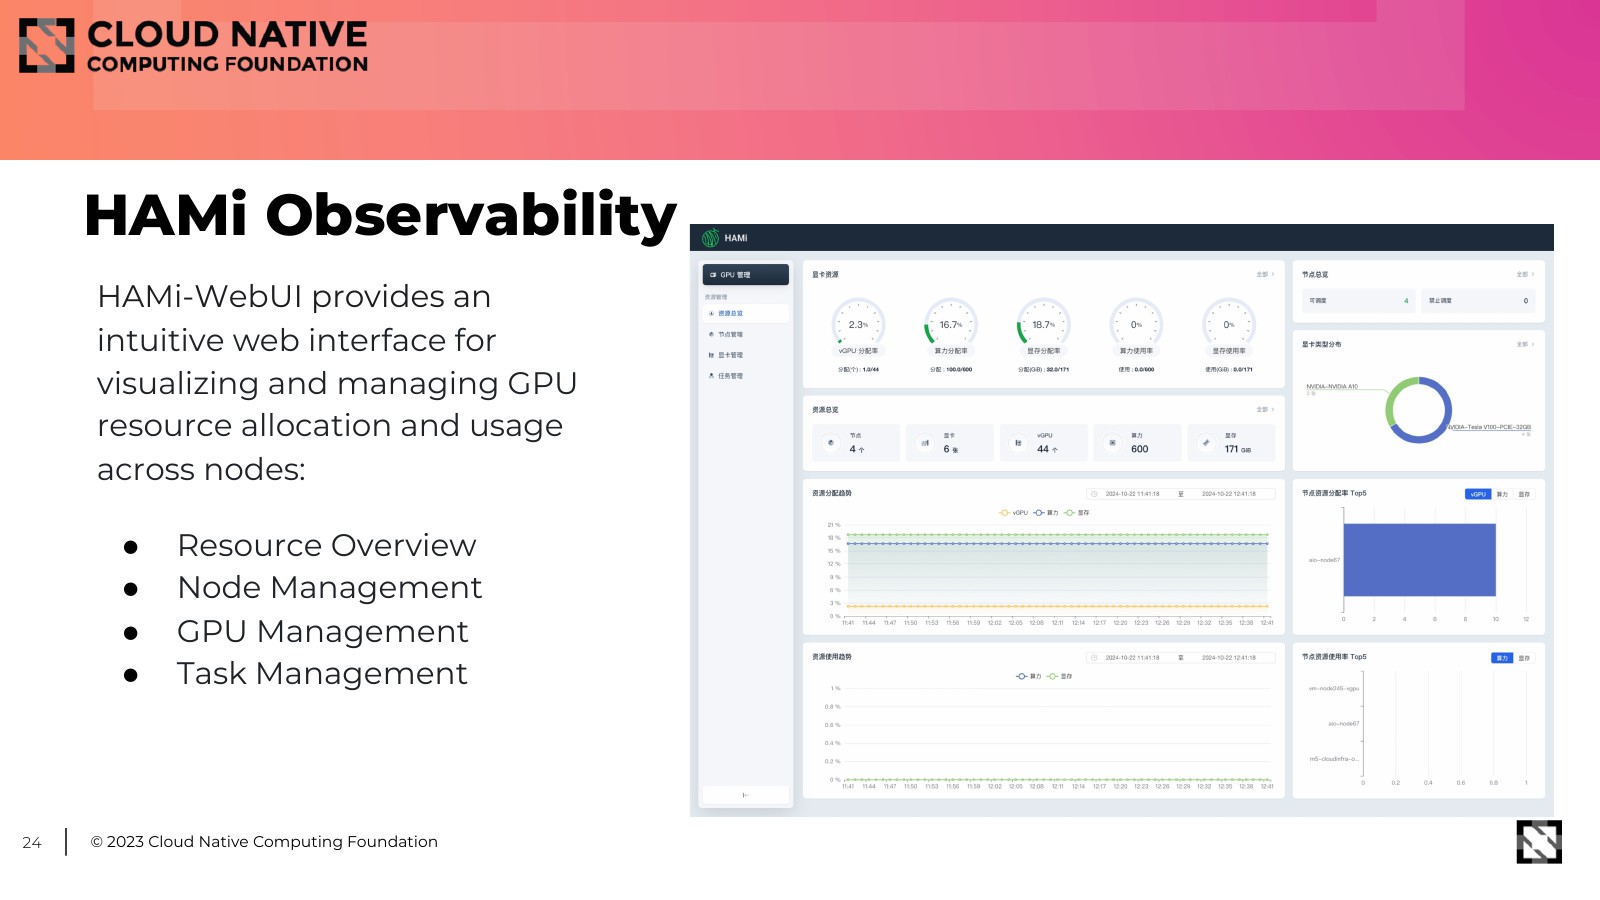
HAMi còn xuất số liệu phân bổ thiết bị trong cụm và mức sử dụng theo thời gian thực cho Prometheus và Grafana, còn HAMi-WebUI cho bạn xem tổng quan node, GPU và task ngay trên trình duyệt.
Bước tiếp theo bọn mình muốn đi
Bọn mình kết thúc bằng chỗ muốn dùng đầu tiên: HAMi với Kubeflow, để một GPU phục vụ được nhiều notebook. Notebook là ví dụ điển hình của GPU được cấp cả ngày mà chỉ bận một phần nhỏ thời gian.
Và đó chính là thứ bọn mình làm tiếp. Hai tháng sau, ở OpenInfra & Cloud Native Day Vietnam 2025, bài nói tiếp theo mở HAMi ra xem bên trong nó hoạt động thế nào và cho thấy nó chạy trong Kubeflow Notebooks: recap bài nói về HAMi. Một năm sau nữa, ở KCD & OpenInfra Days Vietnam 2026, bọn mình quay lại với số liệu production: recap bài nói ở KCD.
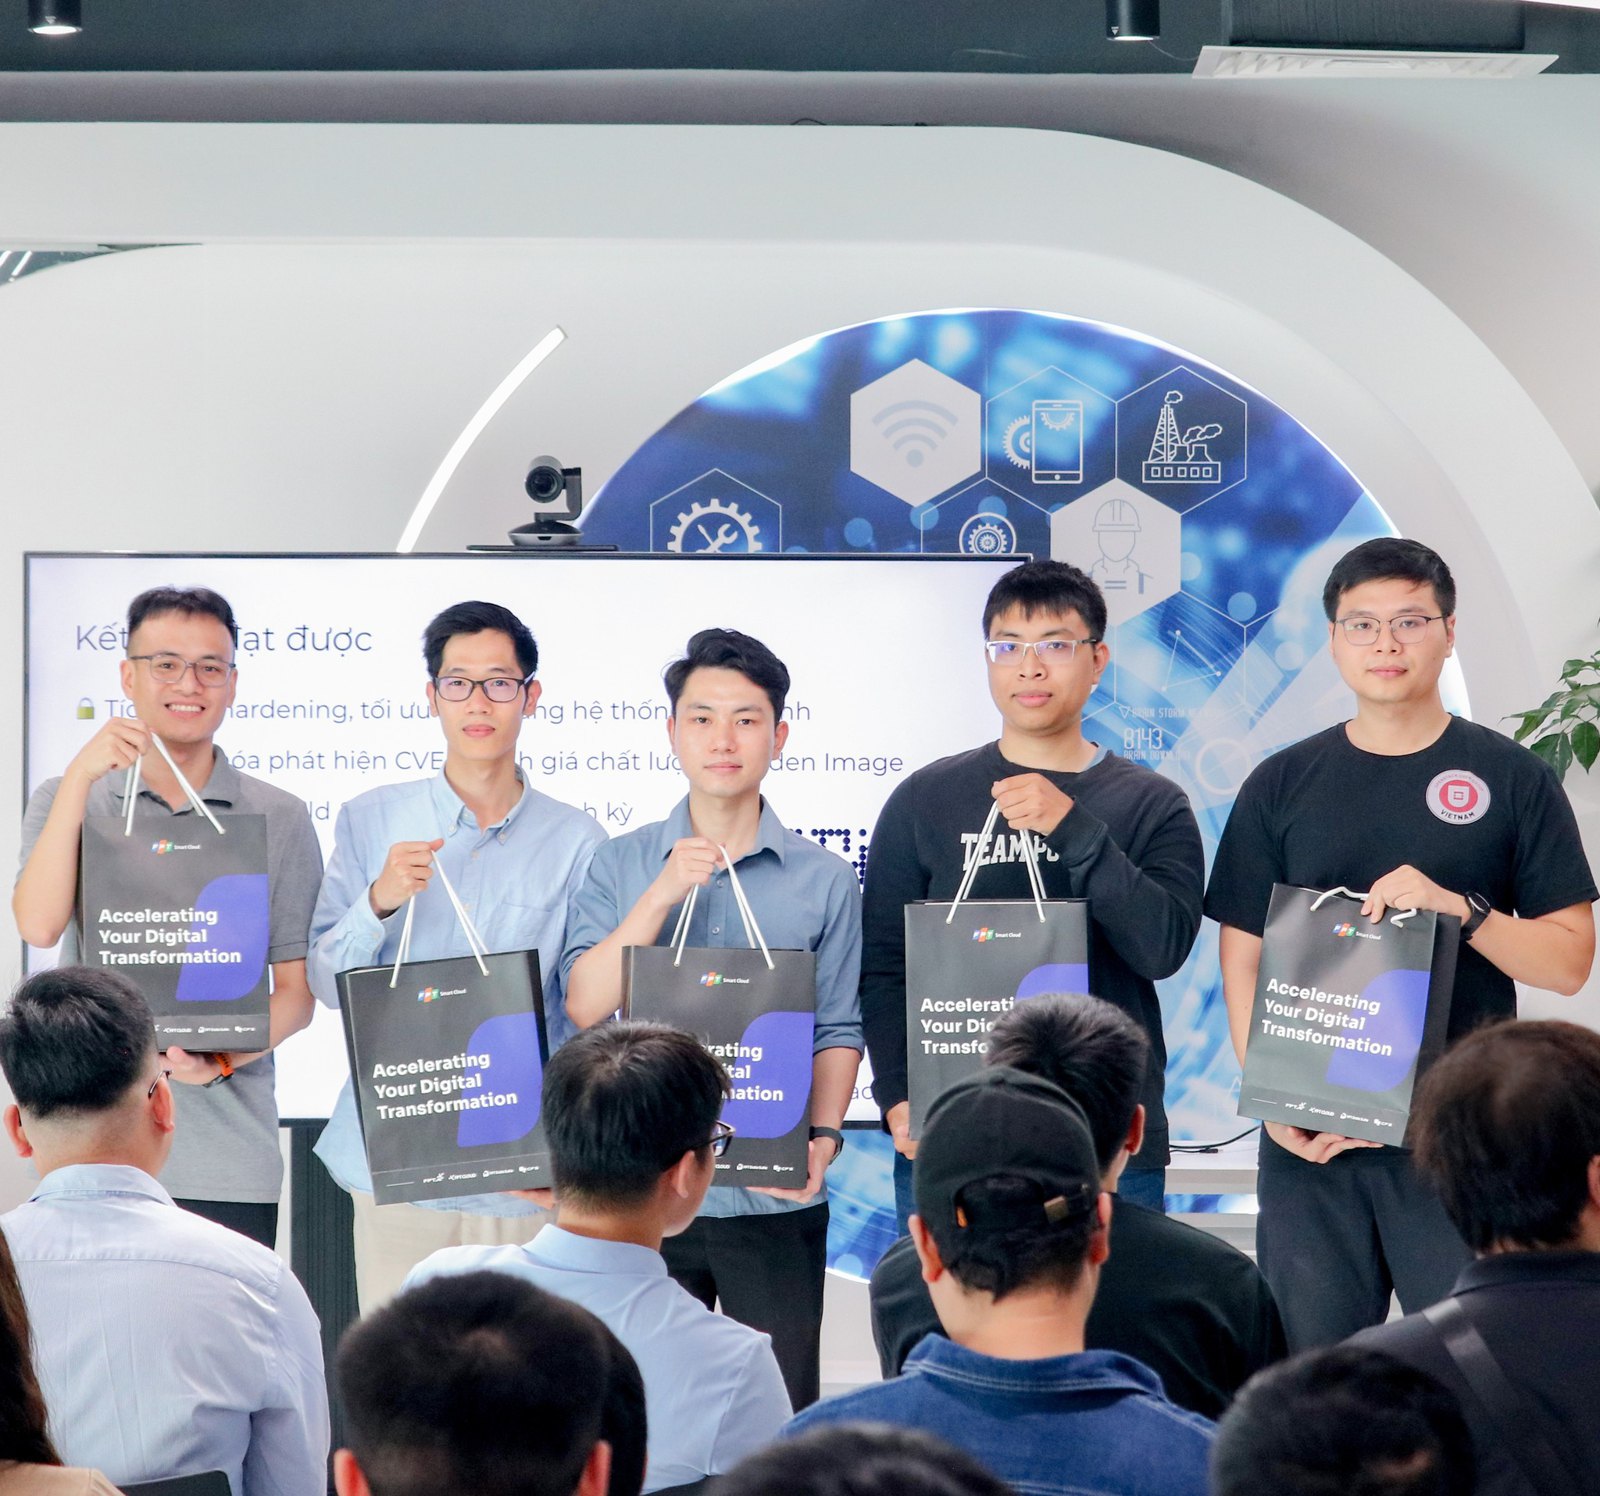
Cảm ơn Cloud Native Hanoi và FPT Smart Cloud đã tổ chức. Nếu bạn đã thử chia GPU theo cách khác trên Kubernetes, mình rất muốn nghe cách nào trụ được.