Recap KCD & OpenInfra Days Vietnam 2026: HAMi, từ project tới production
Gấp 3,4 lần việc trên mỗi GPU từ những card vốn để trống phần lớn, trên một nền tảng Kubernetes AI đã được chứng nhận. Đo được gì, phải làm gì, và chọn job nào để chia card.
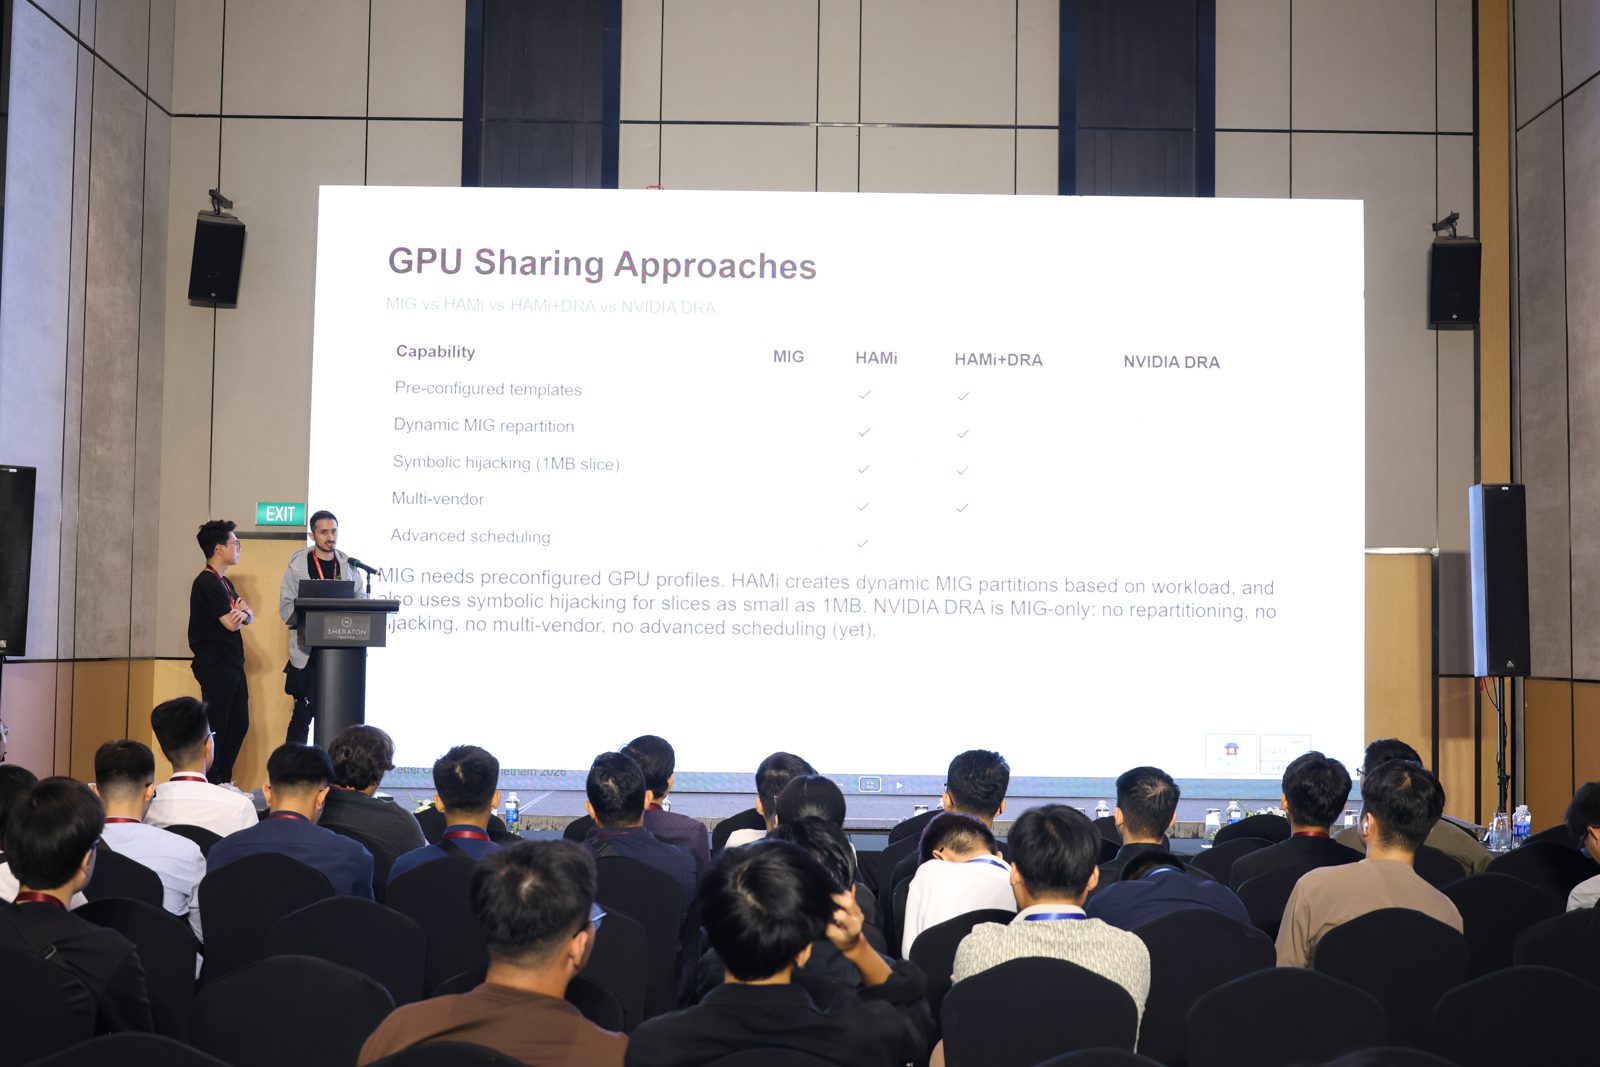
GPU của bọn mình phần lớn để trống, trong khi pod vẫn giữ trọn cả card. Với HAMi, một H200 làm được gấp 3,4 lần việc ở cùng mức latency. Để tới được đó cần làm vận hành thật sự, và phần lời đến từ việc chọn đúng job để dùng chung card. Đó là nửa của mình trong bài nói cùng Reza Jelveh ở KCD & OpenInfra Days Vietnam 2026, ngày 25/7 tại Sheraton Hà Nội.
Điều làm phiên này đáng nghe là sự kết hợp. Reza là Solution Architect ở Dynamia AI, công ty đứng sau HAMi, nên anh ấy mang góc nhìn upstream: project hoạt động thế nào và vì sao. Mình mang góc nhìn downstream từ các cụm GPU của bọn mình: đã đo được gì, hỏng ở đâu, và học được gì.
Phần của Reza: vì sao GPU cần được chia nhỏ
Kubernetes cấp GPU theo kiểu nguyên khối: pod xin nvidia.com/gpu: 1 là nhận cả card, nên một job chỉ cần
1 GB vẫn giữ trọn một card 80 GB, và cấp dư thành chuyện mặc định. DRA cho Kubernetes một cách có cấu trúc
để mô tả và xin thiết bị, nhưng mô tả được một phần GPU không có nghĩa là giới hạn được nó.
HAMi, project CNCF Incubating, lấp đúng chỗ đó. Nó chặn các lời gọi CUDA ngay trong container (thư viện
libvgpu, nạp bằng LD_PRELOAD), nên pod nhận được giới hạn bộ nhớ cứng và một phần compute trên GPU vật
lý. Reza đi qua phần còn lại của bộ công cụ: lập lịch binpack, spread, theo topology, memory
oversubscription, độ ưu tiên, và hỗ trợ cả accelerator ngoài NVIDIA như Ascend, Cambricon. HAMi cũng có
DRA driver, và đó là chỗ hai hướng gặp nhau.
Bên dưới là một nền tảng Kubernetes AI đã được chứng nhận
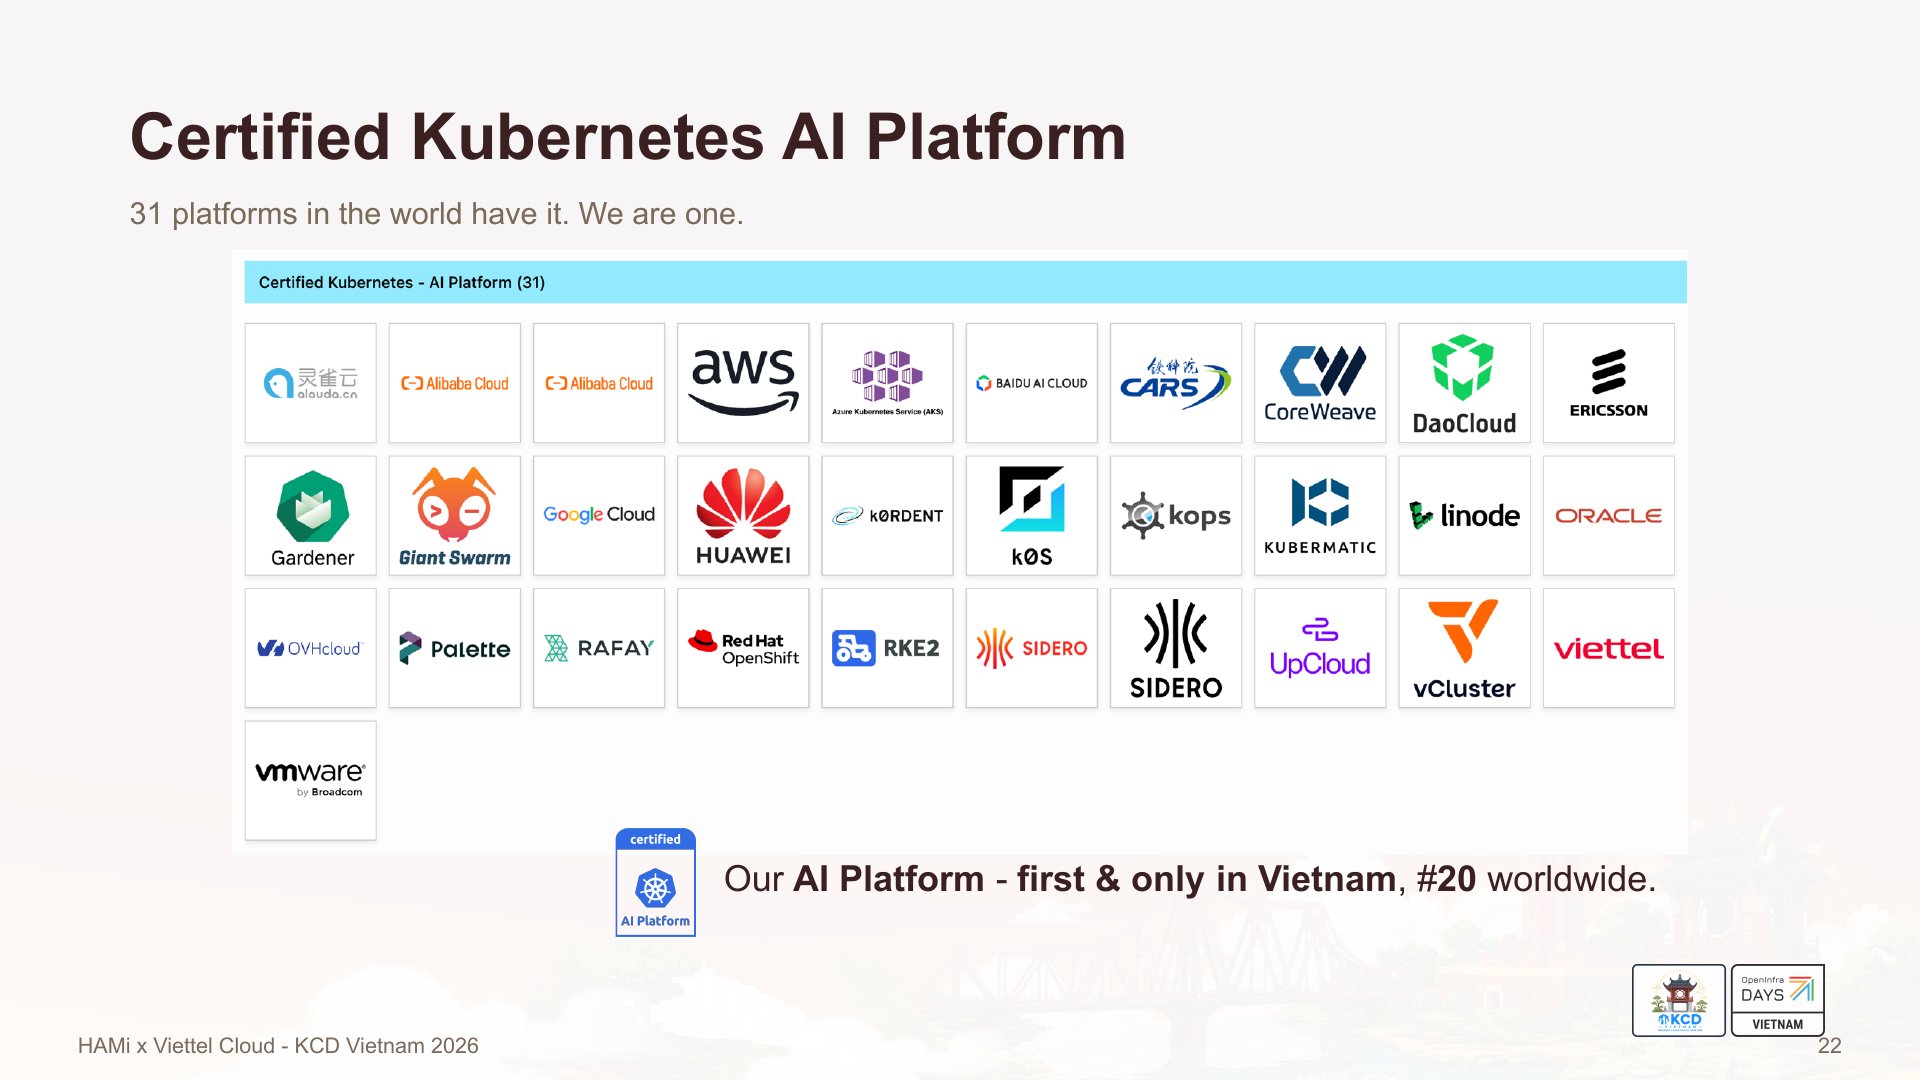
Trước khi vào số liệu là nền tảng nằm bên dưới. Chương trình Kubernetes AI Conformance của CNCF chứng nhận một nền tảng chạy workload AI theo cách chuẩn: hỗ trợ DRA, gang scheduling, metric của accelerator và của service AI, truy cập accelerator an toàn, Gateway API cho inference, và autoscaling cả pod lẫn cluster.
Nền tảng AI của bọn mình được chứng nhận trên Kubernetes v1.35 (hồ sơ conformance). Ở thời điểm buổi nói, đó là một trong 31 nền tảng được chứng nhận trên thế giới, cạnh AWS, Google Cloud, Azure, Oracle và Red Hat OpenShift, và là nền tảng đầu tiên của Việt Nam.
Có hai yêu cầu trong số đó chính là chỗ chia sẻ GPU bị thử thách: truy cập accelerator phải an toàn khi nhiều pod dùng chung một card, và metric của accelerator phải có theo từng pod chứ không chỉ theo GPU vật lý.
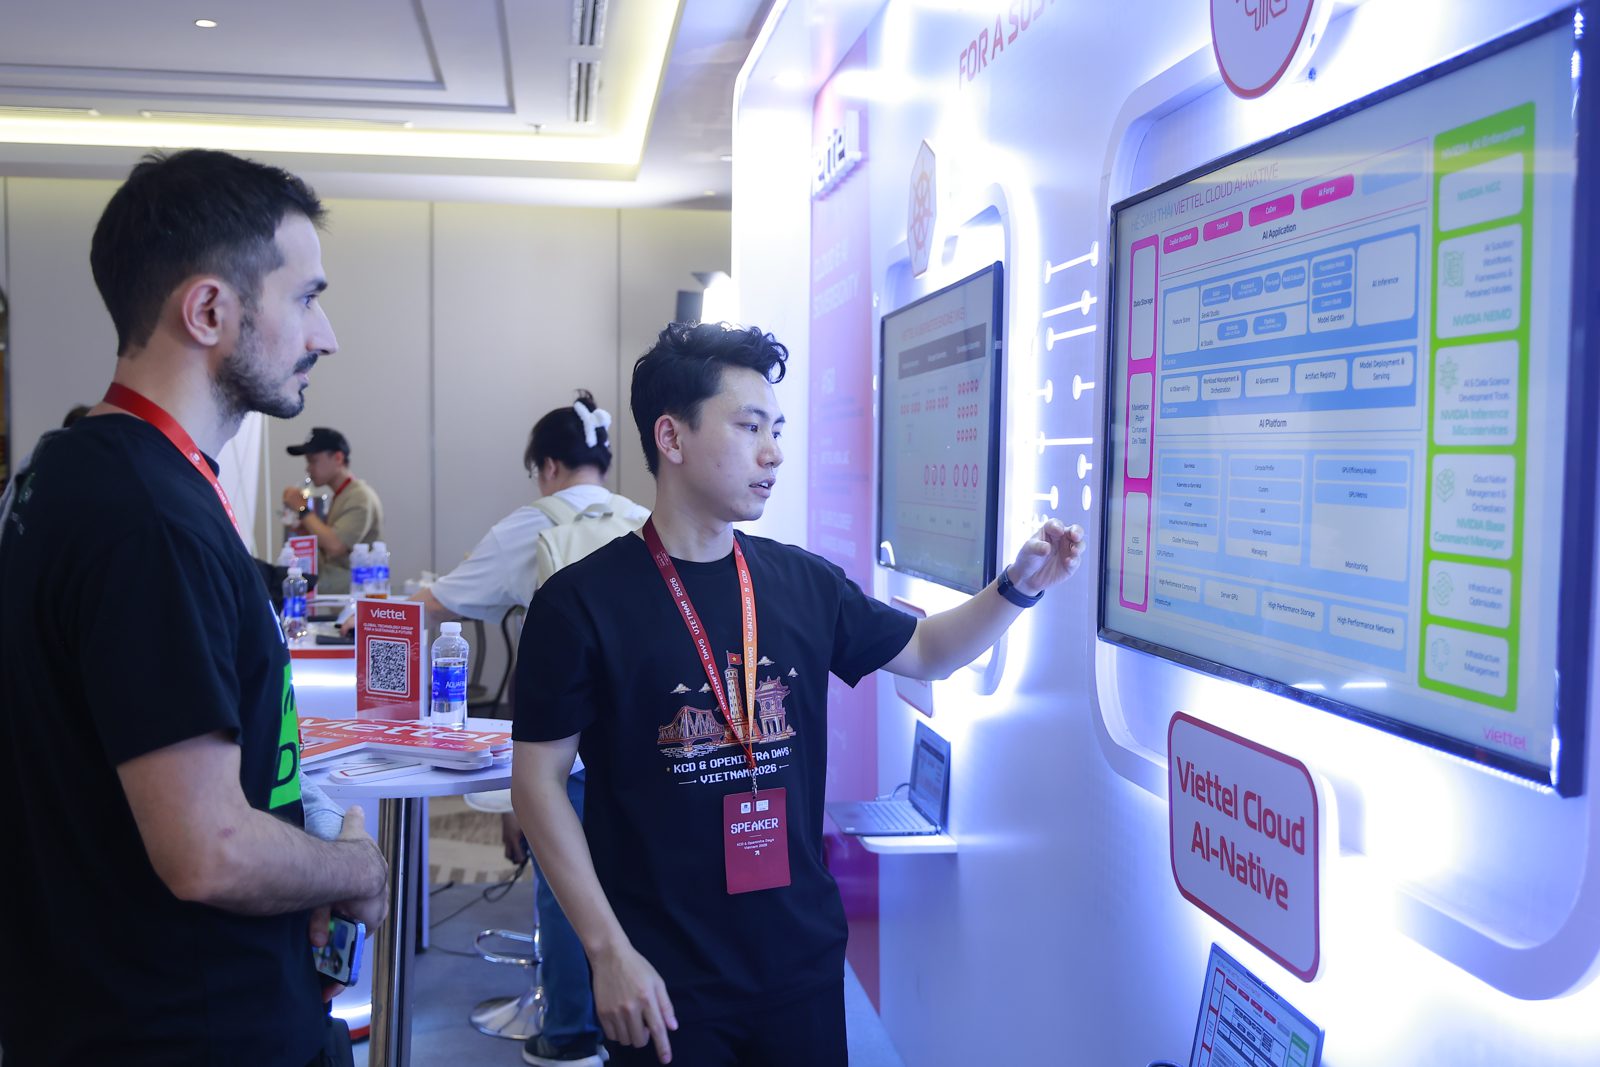
Giới thiệu Viettel AI Platform (Viettel Cloud AI-Native) cho Reza ở gian trưng bày.
Bọn mình chạy những gì
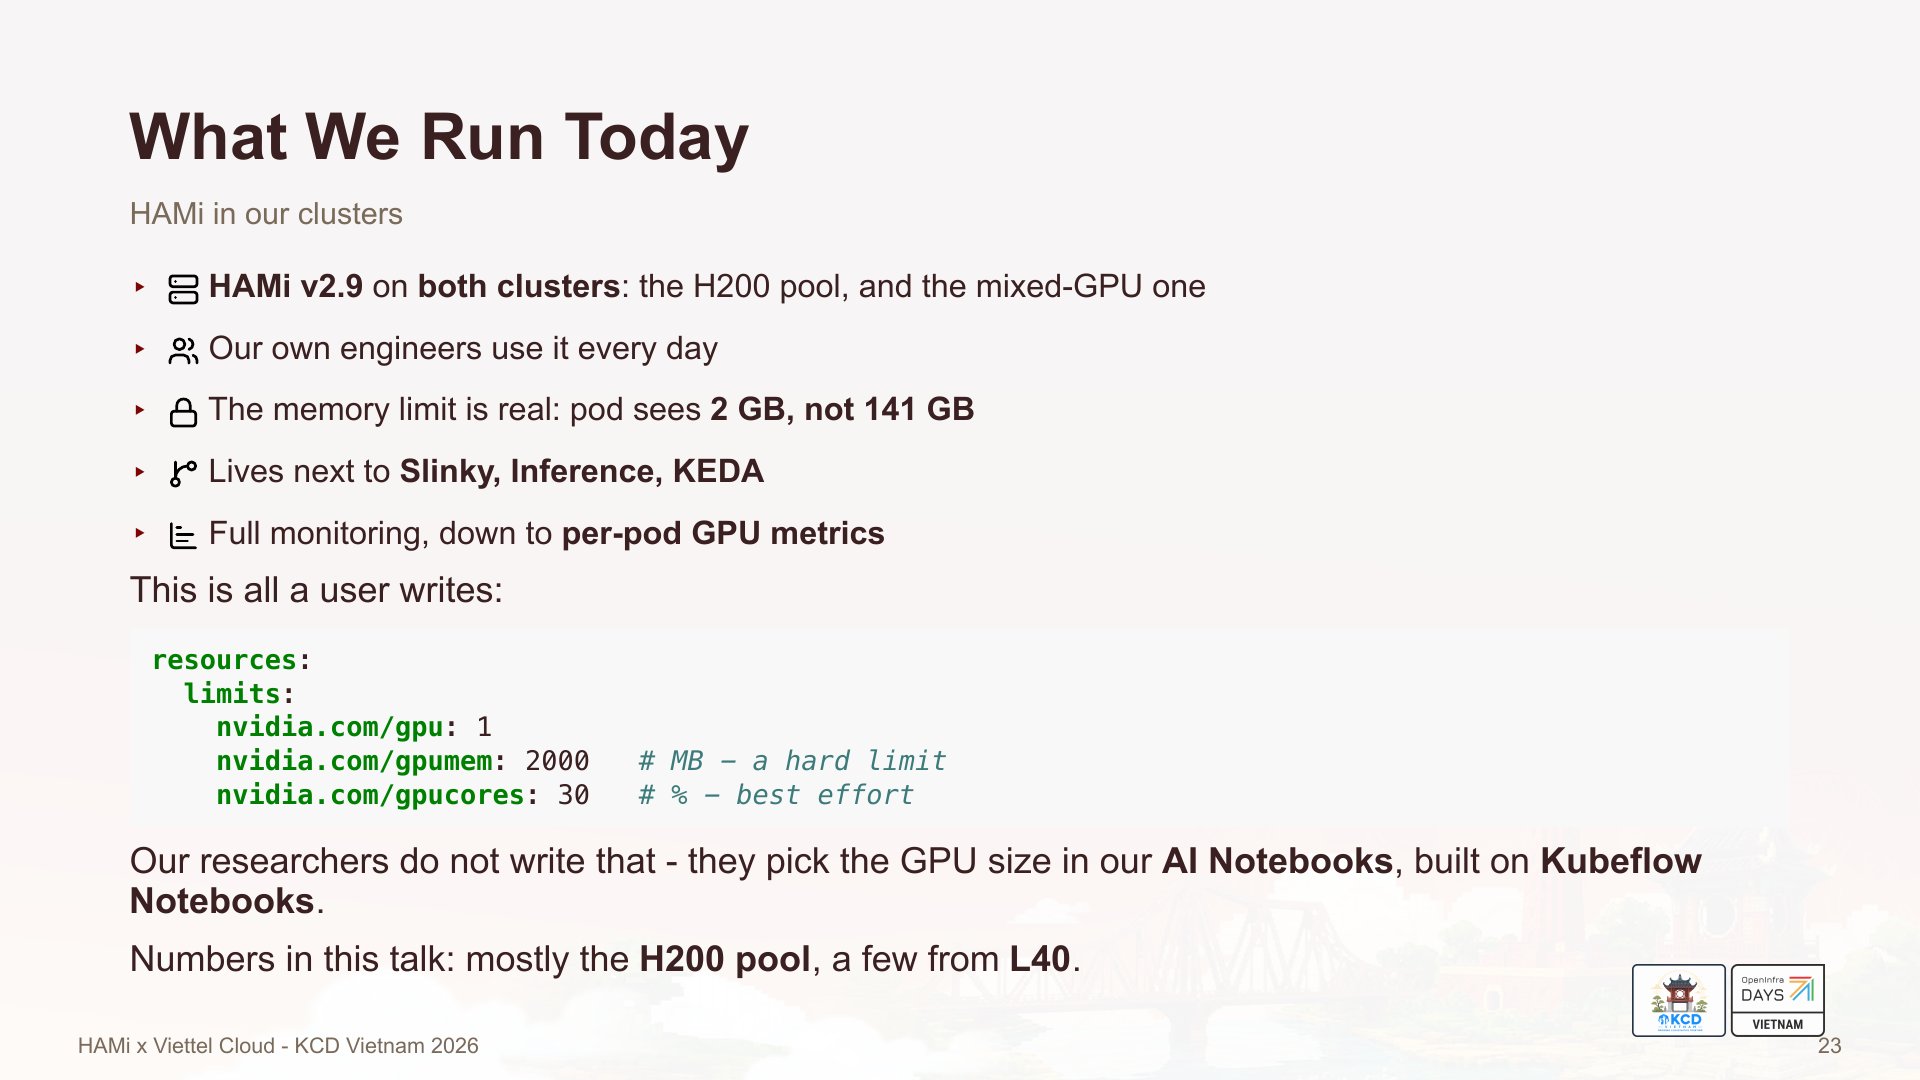
HAMi 2.9 chạy trên cả hai cụm của bọn mình: một pool H200, và một pool GPU hỗn hợp (L40, L40S, A30, A6000).
Nó nằm cạnh Slinky, các workload inference và KEDA, hai scheduler chạy song song. Giới hạn bộ nhớ là thật:
trong pod được cấp 2 GB, nvidia-smi hiện 2 GB chứ không phải 141. Người dùng chỉ cần viết như sau:
resources:
  limits:
    nvidia.com/gpu: 1
    nvidia.com/gpumem: 2000   # MB, giới hạn cứng
    nvidia.com/gpucores: 30   # %, best effort
Phần lớn nhà nghiên cứu còn không phải viết đoạn đó, họ chọn cỡ GPU trên giao diện notebook dựng từ Kubeflow Notebooks. Bọn mình cũng theo dõi được GPU theo từng pod, điều DCGM một mình không làm được vì nó chỉ báo theo GPU vật lý. Phần lớn số liệu dưới đây lấy từ pool H200, một ít từ L40.
Vấn đề, bằng số đo
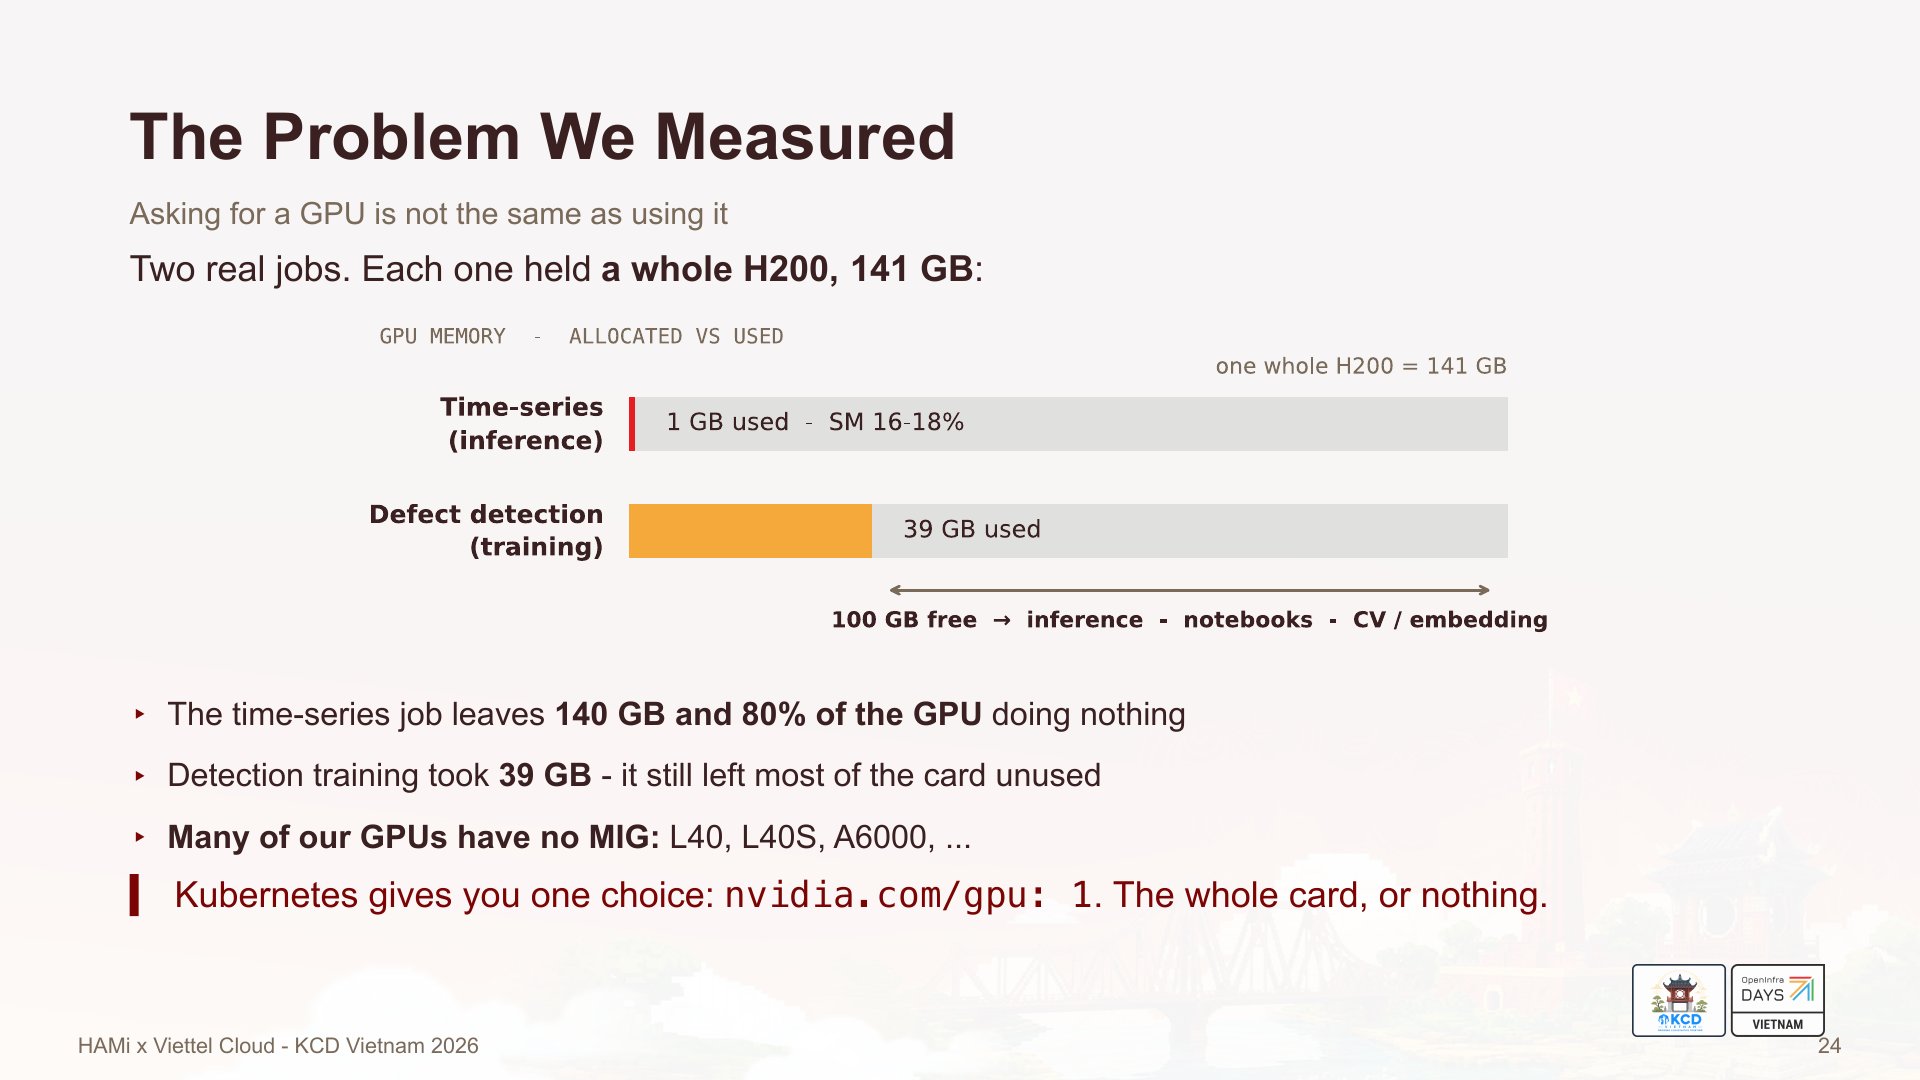
Hai job thật, mỗi job giữ trọn một H200 141 GB:
- Dự báo chuỗi thời gian bằng Chronos, một foundation model khoảng 200 triệu tham số, dự báo tải và telemetry của hạ tầng. Nó dùng 1 GB trên 141, compute 16 đến 18%.
- Một job training trong notebook: YOLO11 trên khoảng 17 nghìn ảnh độ phân giải cao, phát hiện hư hỏng trên tủ điện. Nó dùng 39 GB.
Thế nào cũng có người hỏi sao chỉ 39. Batch size được chọn theo độ chính xác chứ không theo bộ nhớ: model nhỏ, ảnh độ phân giải cao, batch to hơn thì mAP tệ đi. Model đã bận khoảng 90% thời gian, và đẩy tiếp thì data pipeline nghẽn trước khi VRAM kịp đầy. Nên 39 GB là kích thước đúng, và 100 GB còn lại thật sự là thừa.
Điều hay bị quên: L40, L40S và A6000 không có MIG, nên chia GPU bằng phần cứng không phải là lựa chọn trên phần lớn số card đó. Riêng Kubernetes thì chỉ cho một đáp án: cả card hoặc không gì cả.
Gấp 3,4 lần việc trên mỗi GPU
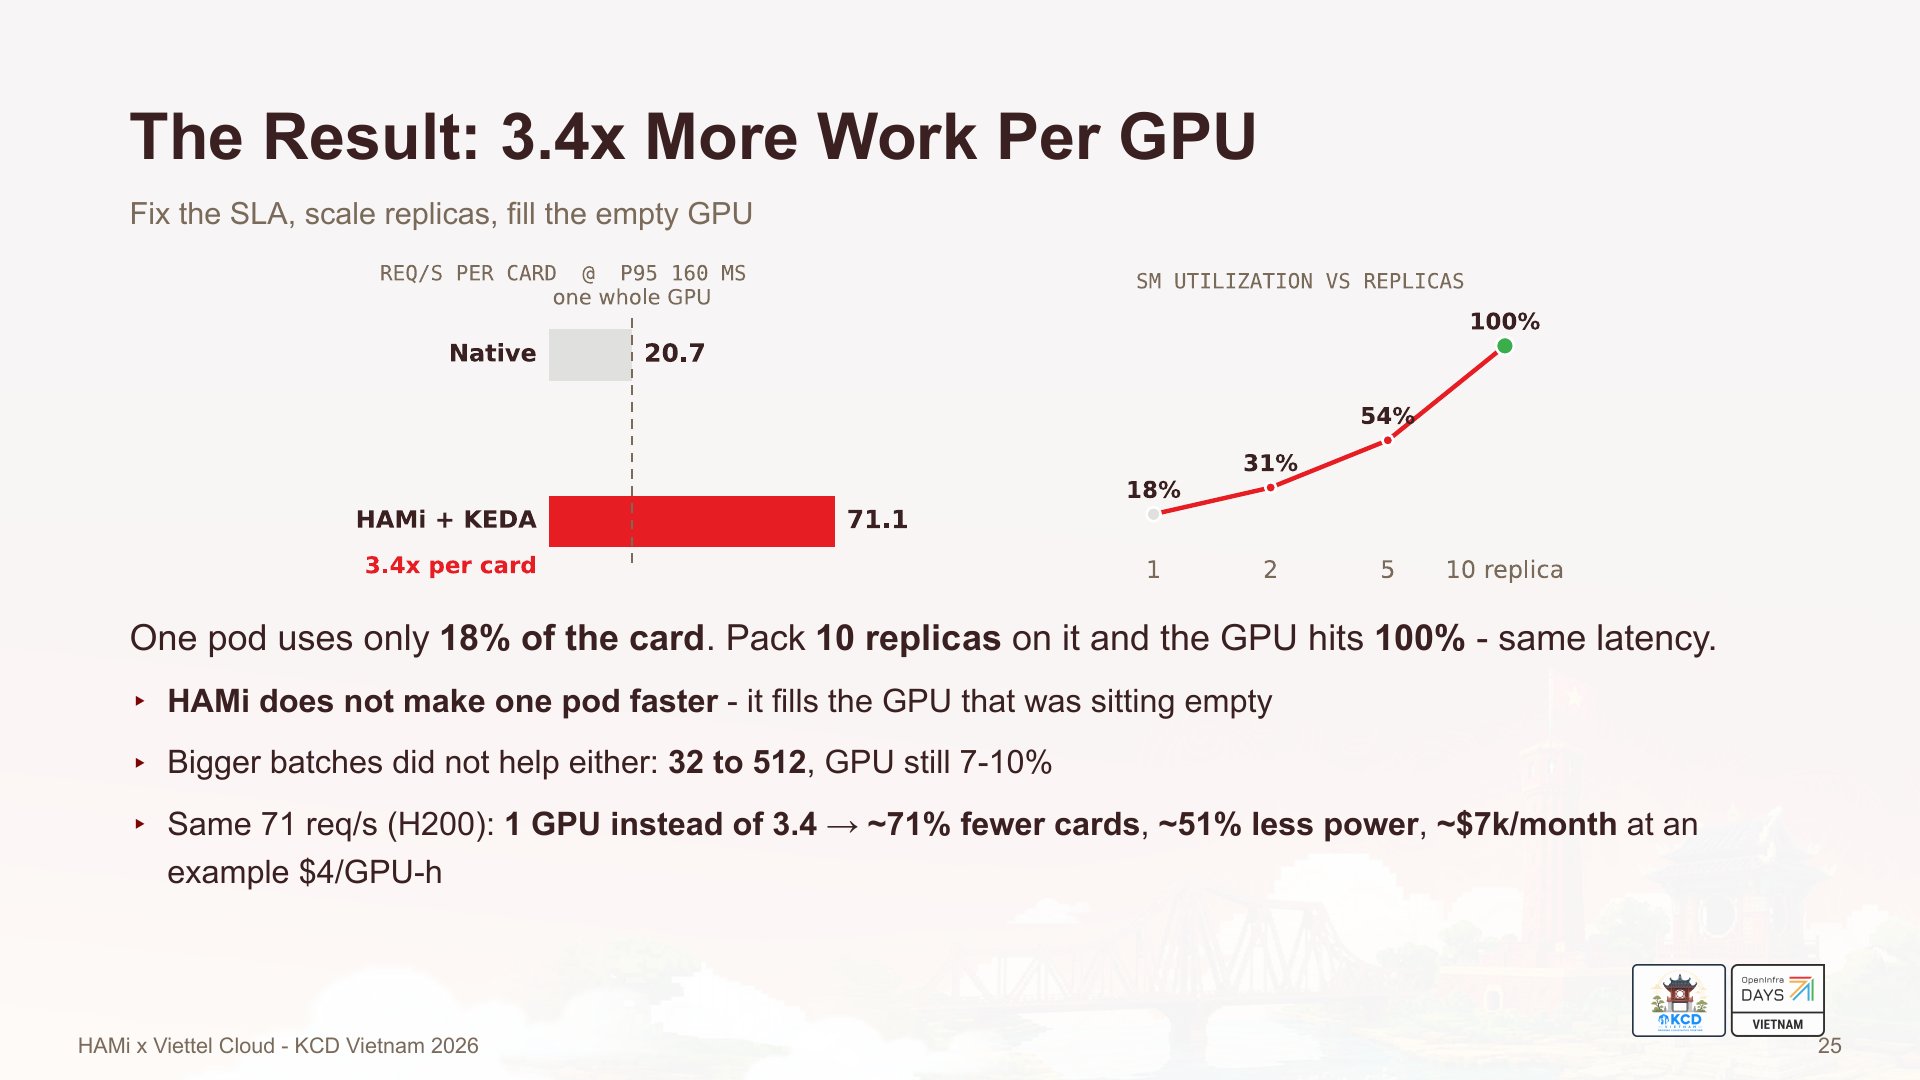
Cùng GPU, cùng job Chronos, cùng mục tiêu latency:
| Cách chạy | Request/s ở P95 160 ms | GPU (SM) dùng |
|---|---|---|
| Một pod, cả card | 20,7 | 18% |
| Một pod, lát HAMi | 19,6 | n/a |
| HAMi + KEDA, scale replica | 71,1 | 100% ở 10 replica |
HAMi không làm một pod nhanh hơn, nó lấp phần GPU đang để trống. Muốn phục vụ 71 req/s theo cách thường thì cần khoảng 3,4 card, ở đây chỉ cần một, tức bớt khoảng 71% số card, và theo công suất đo được thì tốn khoảng một nửa điện.
Lúc mình đưa kết quả này cho team xem, câu đầu tiên là baseline chưa công bằng. Nên bọn mình quay lại thử ba cách. Bỏ hẳn giới hạn latency thì một pod cũng chỉ lên tới 29,6 req/s, P95 từ 57 ms vọt lên 6,2 giây, mà GPU vẫn quanh 10%. Tăng batch từ 32 lên 512 thì GPU vẫn 7 đến 10%. TF32, bfloat16 autocast, đổi dtype đều không cải thiện gì. Một instance của model này không thể lấp đầy H200, tune kiểu gì cũng vậy.
Giữ chỗ thì tốn thời gian, và đó là chủ ý
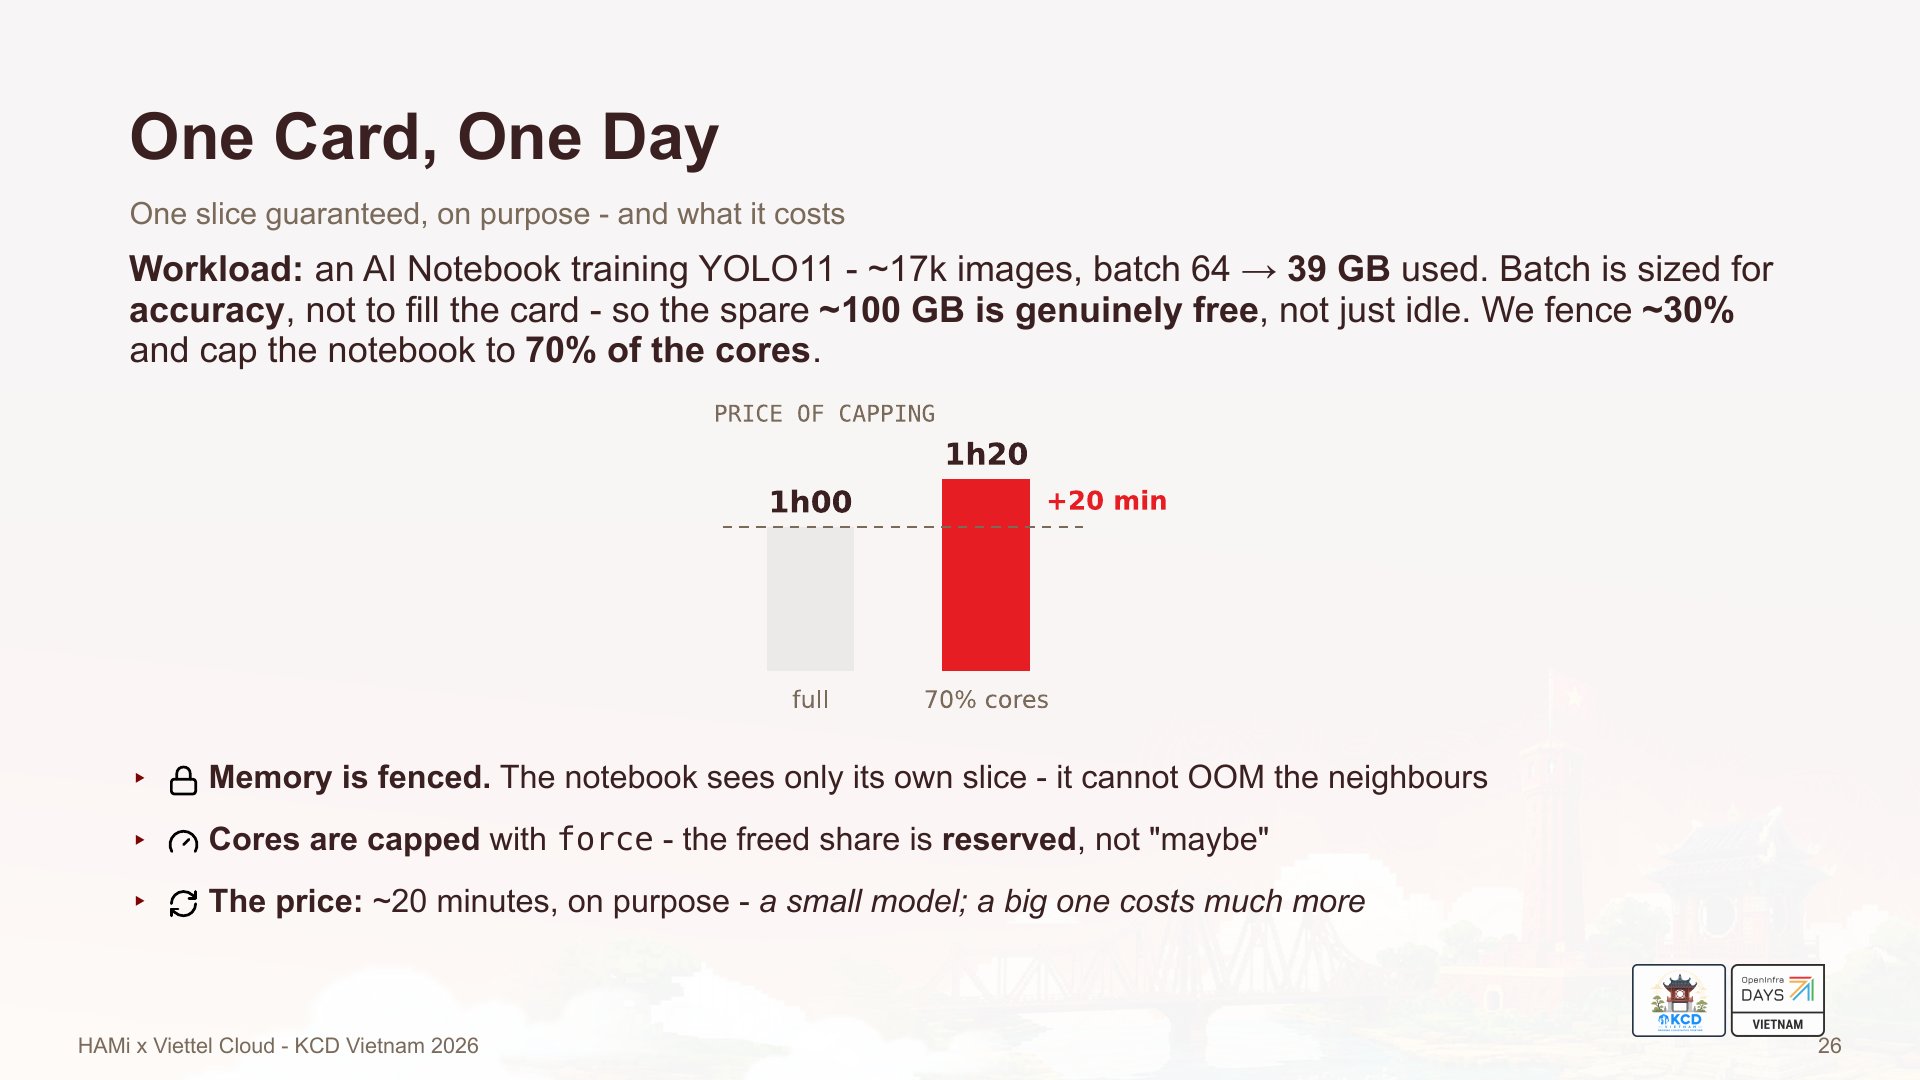
Phần trống được dành cho thứ cần nó: LLM nhỏ, agent, job thị giác máy tính và embedding. Để phần trống đó là thật, chứ không phải “trống nếu training tình cờ đang rảnh”, bọn mình giới hạn notebook:
- Bộ nhớ có rào. Notebook chỉ thấy phần của nó, không thể làm OOM các pod bên cạnh.
- Core bị giới hạn bằng
force, ở mức 70%, nên phần còn lại của card được giữ thật. - Cái giá là khoảng 20 phút. Một lần training từ 1 tiếng thành 1 tiếng 20. Rẻ với model nhỏ, còn với model lớn thì không rẻ chút nào.
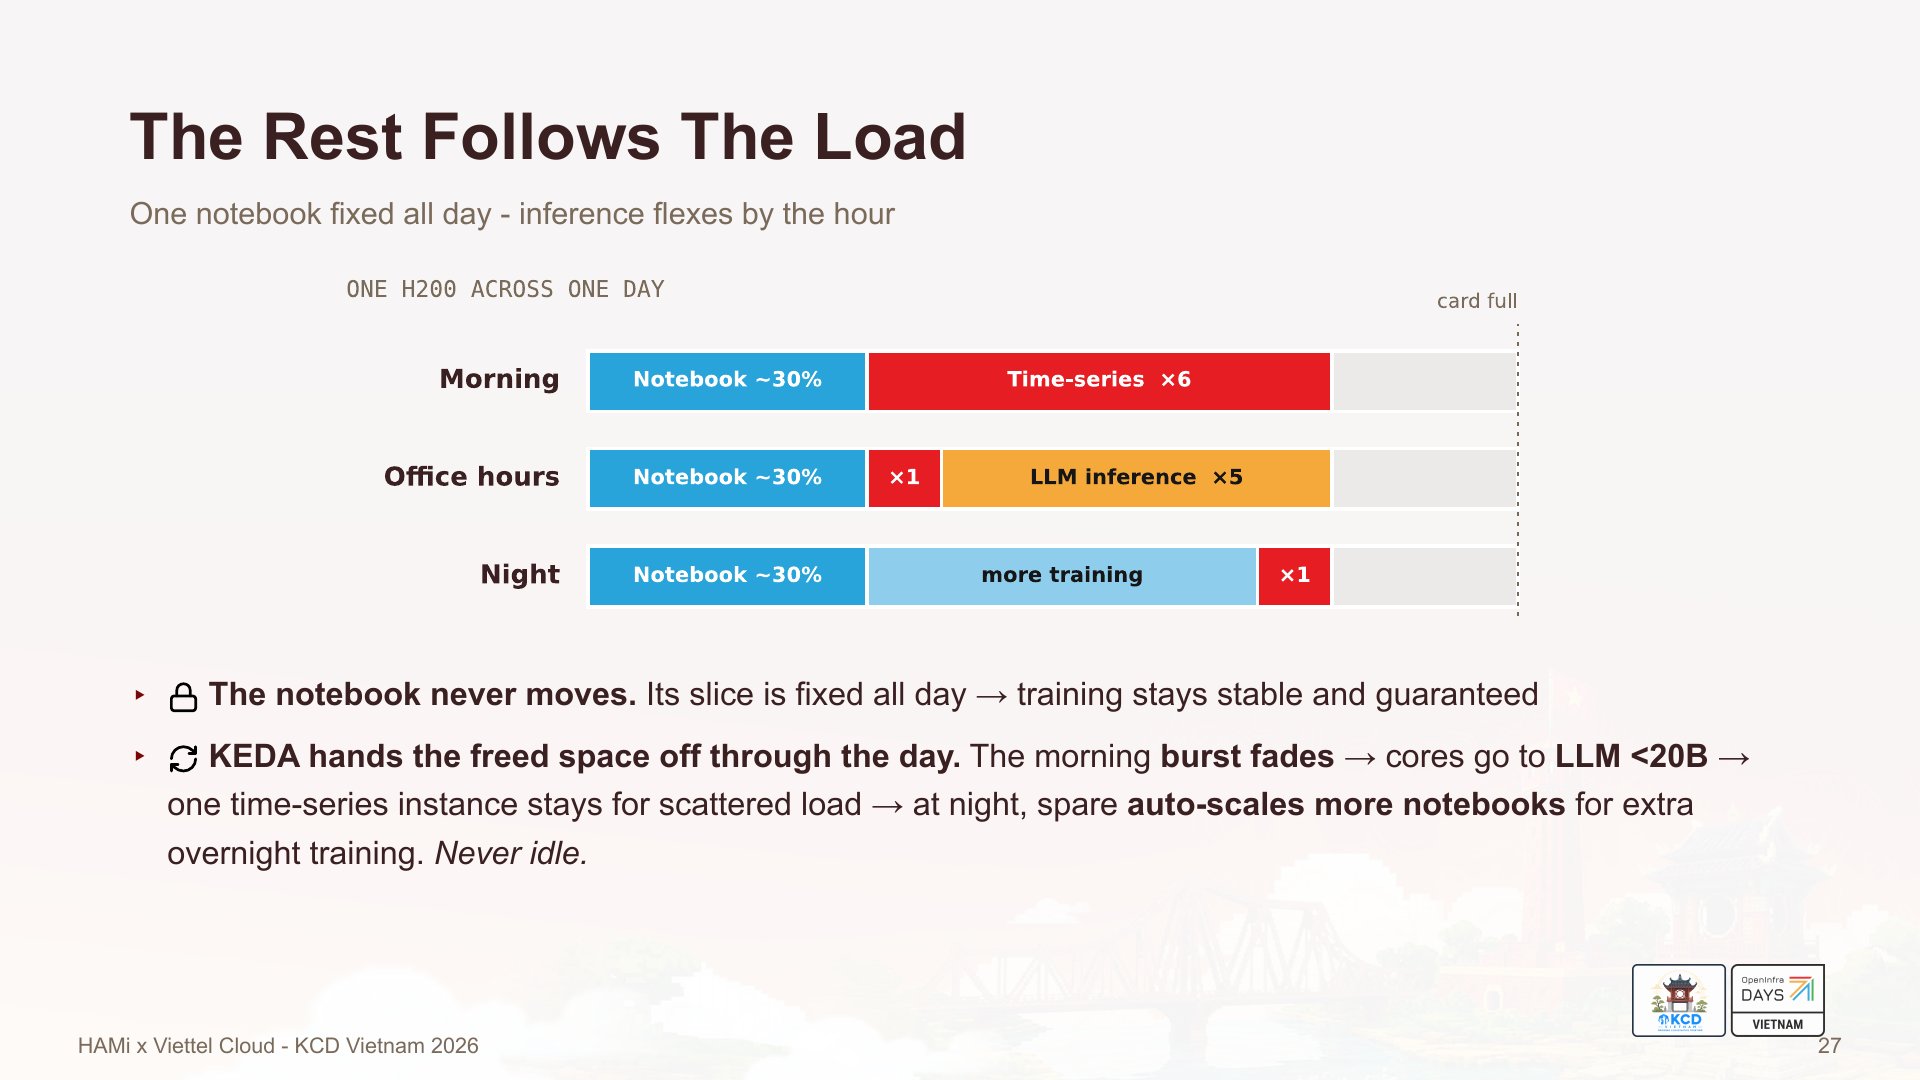
Trong một ngày, khối notebook không bao giờ đổi, còn mọi thứ khác đi theo tải. Sáng sớm, dự báo tăng vọt lên sáu instance. Giờ hành chính, inference LLM với các model dưới 20B chiếm chỗ. Ban đêm, chạy thêm notebook và training thay vì để card nằm không.
Chọn đúng job để chia card
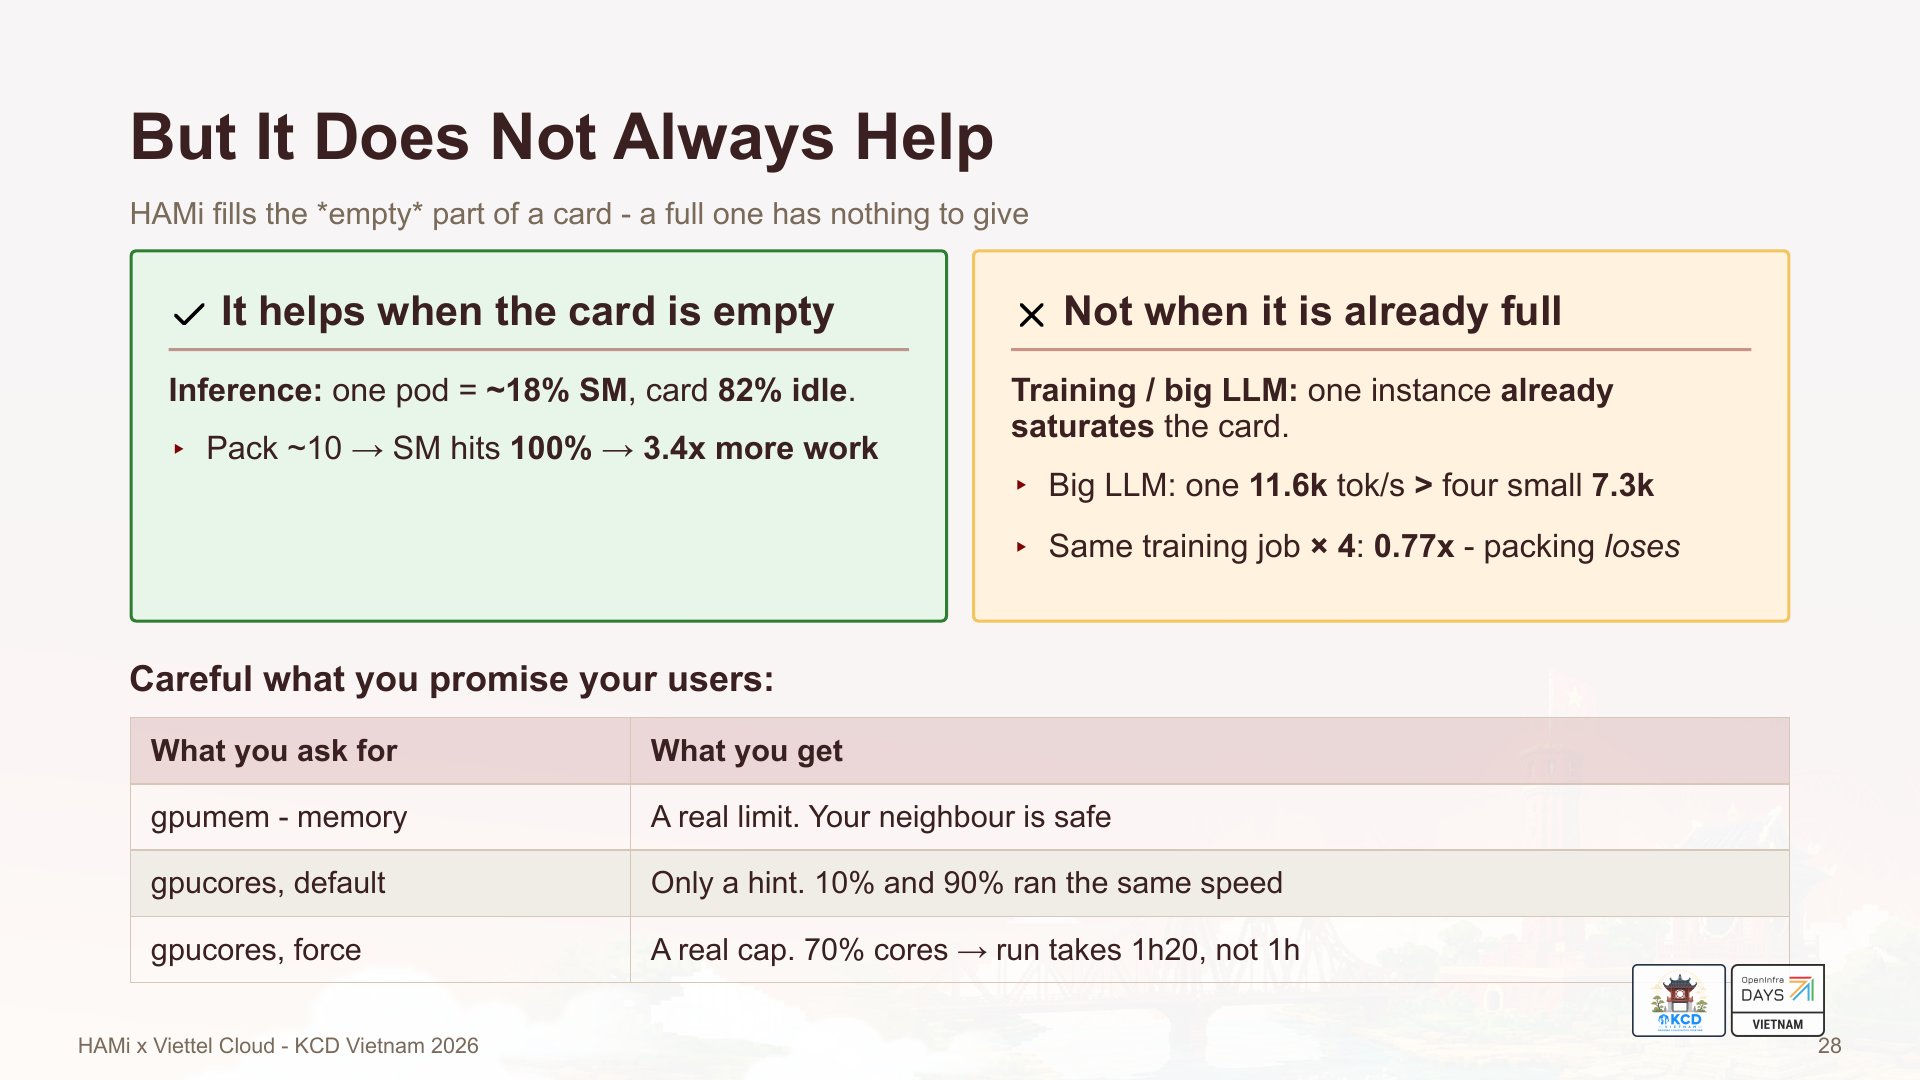
Nếu chỉ được giữ một slide thì mình giữ slide này. Fractional GPU có lợi khi job nhỏ hoặc chạy theo đợt và không tự lấp đầy card được. Nó không có lợi khi job đã dùng kín GPU, và bọn mình đo điều đó hai lần:
- Serve LLM. SGLang trên một H200: một instance lớn cho 11,6 nghìn token/s, bốn instance nhỏ chỉ được 7,3 nghìn, vì continuous batching vốn đã giữ GPU bận.
- Training. Cùng một job LSTM, xếp 1, 2 rồi 4 bản trên một card: tổng lần lượt 2.779, 2.278 rồi 2.148 sample/s. Ở mức 4 bản, tổng chỉ bằng 0,77 lần một job.
Khi card đã đầy, xếp chung chỉ mang lại cô lập và chia đều, chứ không thêm throughput.
Cũng cẩn thận với điều mình hứa với người dùng. gpumem là giới hạn thật. gpucores chỉ là gợi ý: hai pod
được cấp 10% và 90% của cùng một card, chạy cùng workload, ra cùng tốc độ, khoảng 11 ops/s mỗi pod. Khi
tranh nhau thì nó thành chia đều. Có force thì giới hạn mới thành thật, với cái giá vừa nói ở trên. Hứa về
bộ nhớ thì được, đừng hứa về compute.
Thật sự phải làm những gì
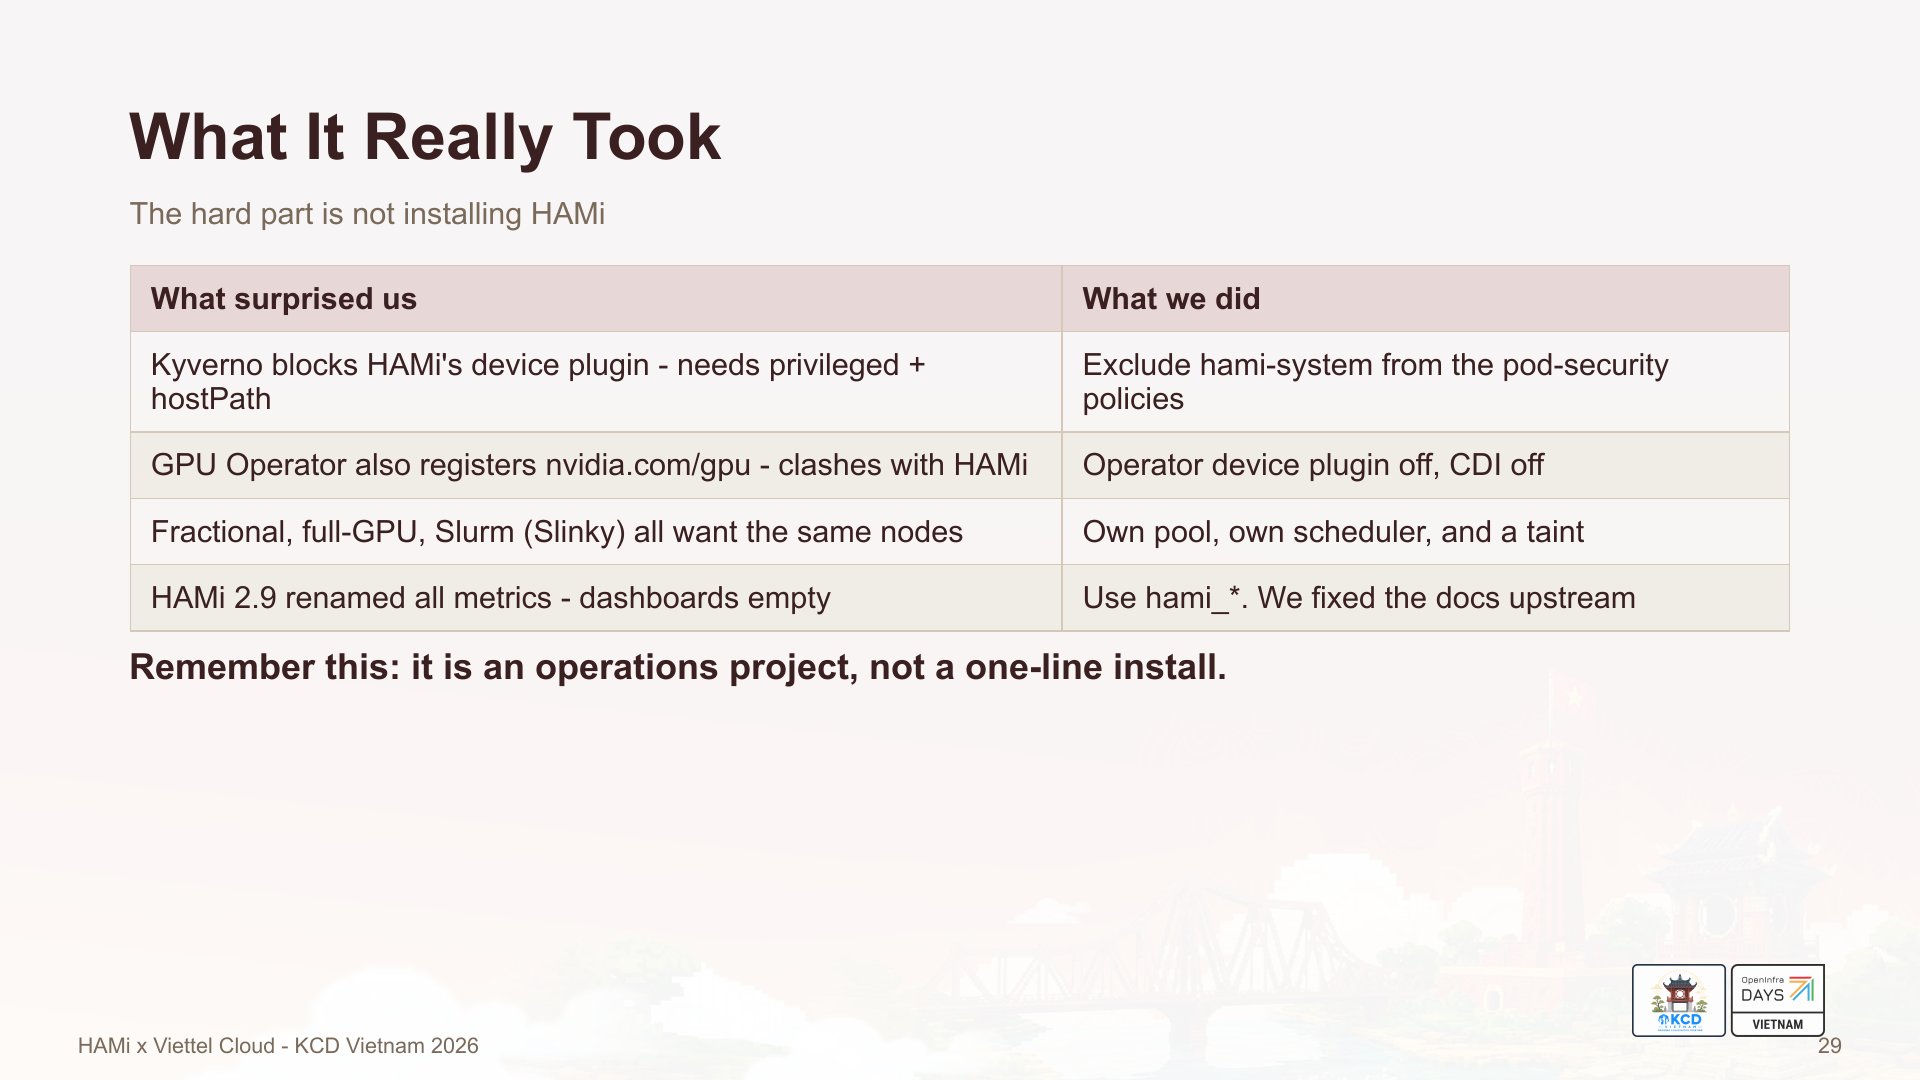
Helm chart là phần dễ nhất.
- Kyverno chặn HAMi. Device plugin của nó cần host path, driver và socket của kubelet, nên phải chạy
privileged, mà policy của bọn mình chặn đúng kiểu đó. Bọn mình chỉ thêm ngoại lệ cho namespace
hami-system. - GPU Operator cũng đăng ký
nvidia.com/gpu. Bọn mình tắt device plugin của operator, và tắt CDI: ở chế độ CDI, toolkit tự nối thiết bị theo cách của nó, còn thư viện của HAMi cần đường runtime legacy. - Pod fractional, pod nguyên GPU và Slinky giành node của nhau. HAMi được tách pool riêng, scheduler riêng và một taint.
- HAMi 2.9 đổi tên toàn bộ metric, dashboard trống trơn. Bọn mình chuyển sang tên mới và gửi bản sửa docs lên upstream (website#498).
Nếu chỉ nhớ một điều thì đó là: đây là một dự án vận hành, không phải một lệnh cài.
Chỗ phép màu hết linh
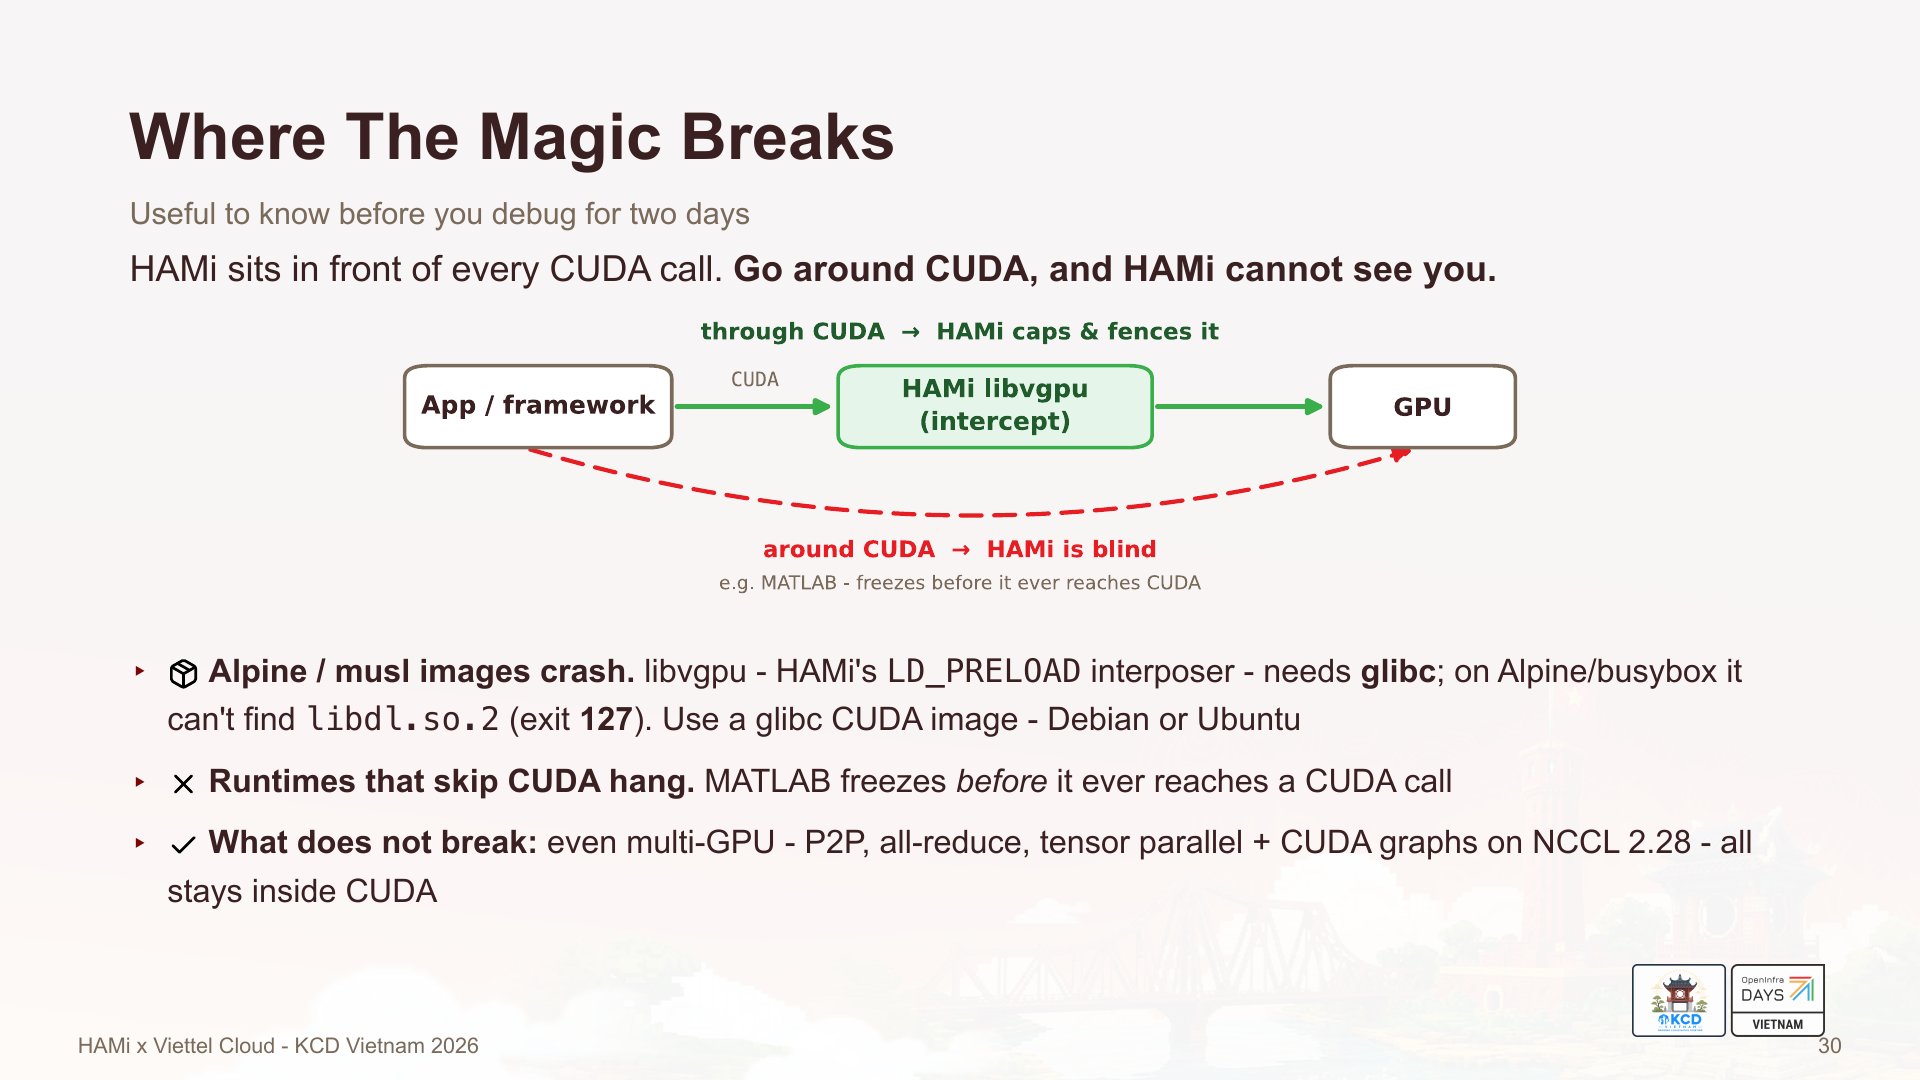
HAMi đứng trước mọi lời gọi CUDA, nên thứ gì đi vòng qua CUDA thì nó không thấy. Những gì nằm trong CUDA thì vẫn ổn, kể cả multi-GPU: peer-to-peer, all-reduce, tensor parallel với CUDA graph đều chạy được trên NCCL 2.28, và cả NCCL cũ bị ép đi đường legacy cũng vậy.
Có hai chỗ hỏng thật. Image musl (Alpine, busybox) không nạp được libvgpu vì thư viện này cần glibc:
container chết với libdl.so.2 not found và exit code 127 trước khi code của bạn kịp chạy, cách sửa là dùng
base image có glibc. Còn MATLAB thì treo trước khi kịp gọi tới CUDA, vì HAMi chờ ở tầng CUDA mà MATLAB
không bao giờ tới đó.
Tiếp theo
Thêm pool GPU, thêm nhiều loại workload dùng chung một card, và chuyển sang DRA: vẫn mức cô lập đó, nhưng xin GPU theo cách chuẩn của Kubernetes thay vì qua tên resource riêng. Và lý do bọn mình chọn HAMi ngay từ đầu là multi-vendor: GPU của bọn mình sẽ không phải lúc nào cũng là NVIDIA, mà HAMi đã hỗ trợ sẵn Ascend, Cambricon và nhiều loại khác.
Đọc thêm
- HAMi trên GitHub, và trang của project.
- Vài tuần sau, mình được HAMi ghi nhận đóng góp cho project qua chương trình Contributor Recognition.
Cảm ơn Reza đã cùng đứng chung sân khấu, cảm ơn các maintainer của HAMi, và ban tổ chức KCD & OpenInfra Days Vietnam.
Fractional GPU biến những card vốn để trống phần lớn thành gấp 3,4 lần việc. Cái khó nằm ở chỗ biết job nào để trống card, và vận hành nền tảng sao cho chúng dùng chung card một cách an toàn. Nếu bạn đã chạy HAMi hay DRA trên GPU của mình mà thấy ranh giới nằm ở chỗ khác, mình rất muốn nghe :)