Recap meetup VOI & CNVN x AWS FCAJ: biến GPU-hour thành token, và token thành dịch vụ
Phần lớn chia sẻ dừng ở tầng serving. Bài này nói về kiến trúc tổng thể bao quanh nó: phục vụ nhiều tenant trên nhiều cụm GPU mà vẫn scale được, bảo trì được.
Bấm vào ảnh bìa để xem toàn bộ slide.
Tách control plane khỏi data plane thì một nền tảng GPU lớn lên được theo từng component: thêm cụm mới, đổi engine, nâng gateway, mỗi thứ thay hay nâng cấp riêng mà không đụng phần còn lại. Đó là sợi chỉ xuyên suốt bài nói của mình và Minh, thành viên trong team, hôm nay ở Cloud & AI Infrastructure, buổi meetup cộng đồng tại văn phòng AWS ở Hà Nội. Phần lớn câu hỏi sau buổi nói cũng đổ vào đúng chỗ này.
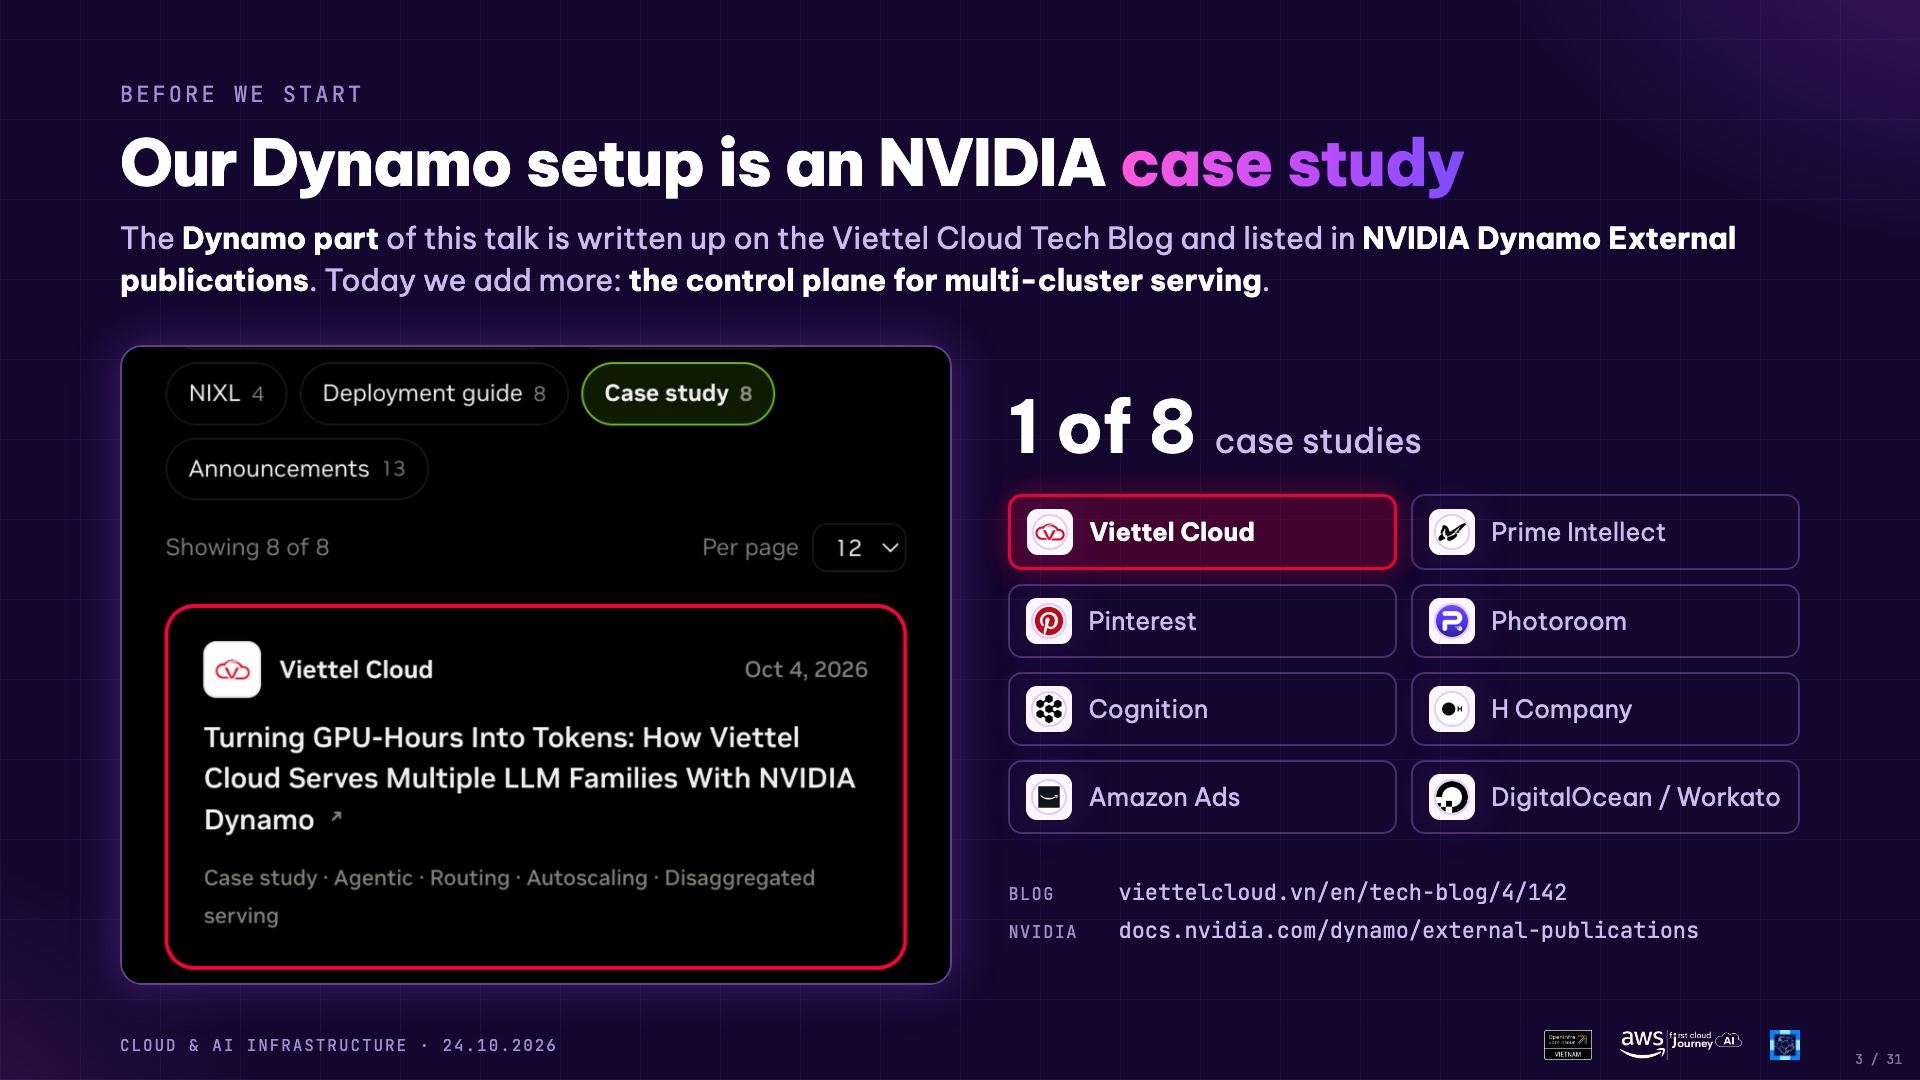
Phần NVIDIA Dynamo bọn mình đã có bài viết đầy đủ, và NVIDIA đã đưa bài đó vào mục case study trong docs của Dynamo. Bài đó nói về việc vắt thêm token từ mỗi GPU, nhưng chưa kể tầng bao quanh nó.
Phần lớn những gì mình đọc về LLM đều dừng ở tầng serving: engine nào nhanh hơn, route thế nào, scale ra sao. Nhưng để thành một dịch vụ cho nhiều tenant thì cần cả một kiến trúc tổng thể bao quanh: quản lý endpoint trên nhiều cụm, xác thực từng request, giới hạn ai được gọi model nào và được dùng bao nhiêu, ghi lại usage của từng request. Và tất cả phải scale được, bảo trì được khi số cụm và số model cứ tăng lên.
Bức tranh trọn vẹn đó thì mình ít thấy ai chia sẻ, nên đó là phần buổi nói kể thêm, và bài recap này cũng đi sâu vào đó.
Năng lực tính bằng gigawatt, đầu ra là token
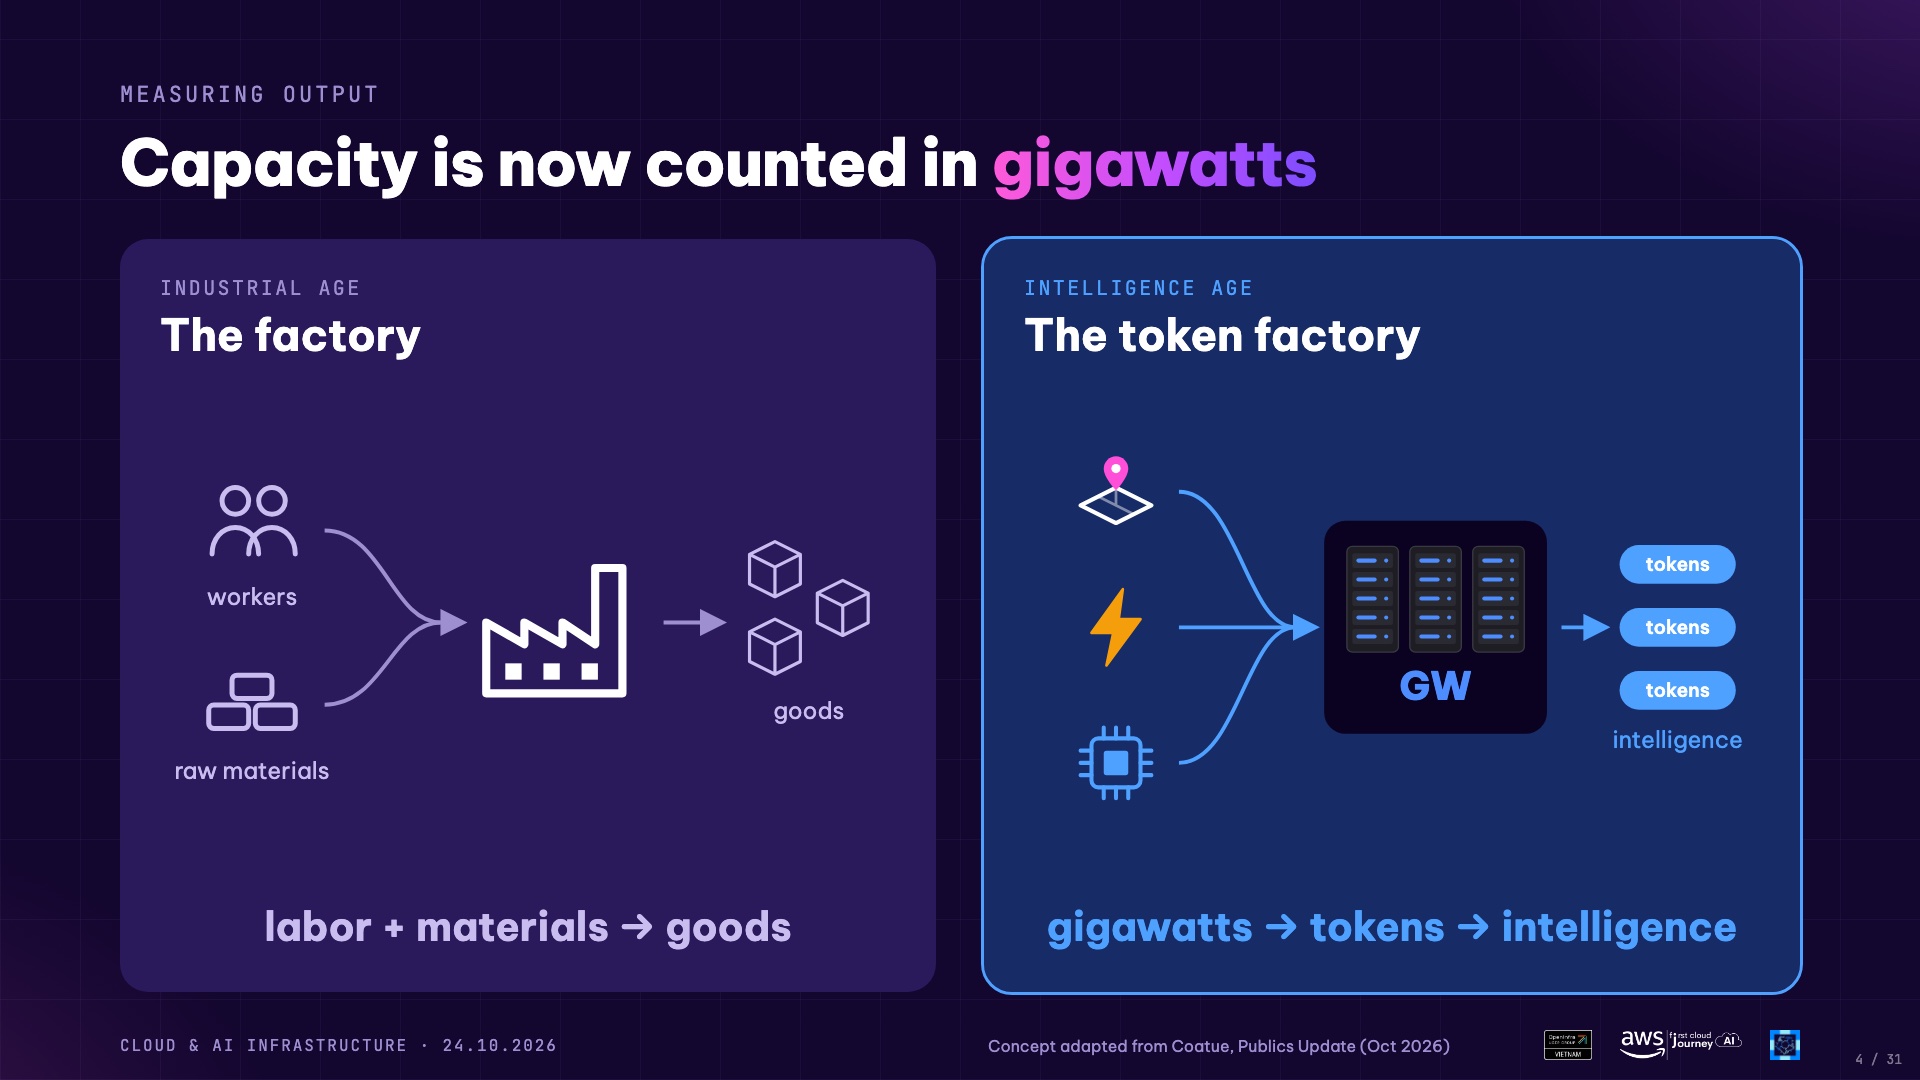
Thời công nghiệp, muốn biết một nhà máy lớn cỡ nào thì người ta hỏi có bao nhiêu công nhân, bao nhiêu nguyên liệu và làm ra bao nhiêu hàng. Bây giờ nói về hạ tầng AI thì người ta hỏi một câu khác: data center này bao nhiêu gigawatt. Đầu vào đổi thành đất, điện và chip, còn đầu ra là token. Ý tưởng này mình mượn từ báo cáo Publics Update của Coatue (tháng 10/2026), hình thì mình vẽ lại.
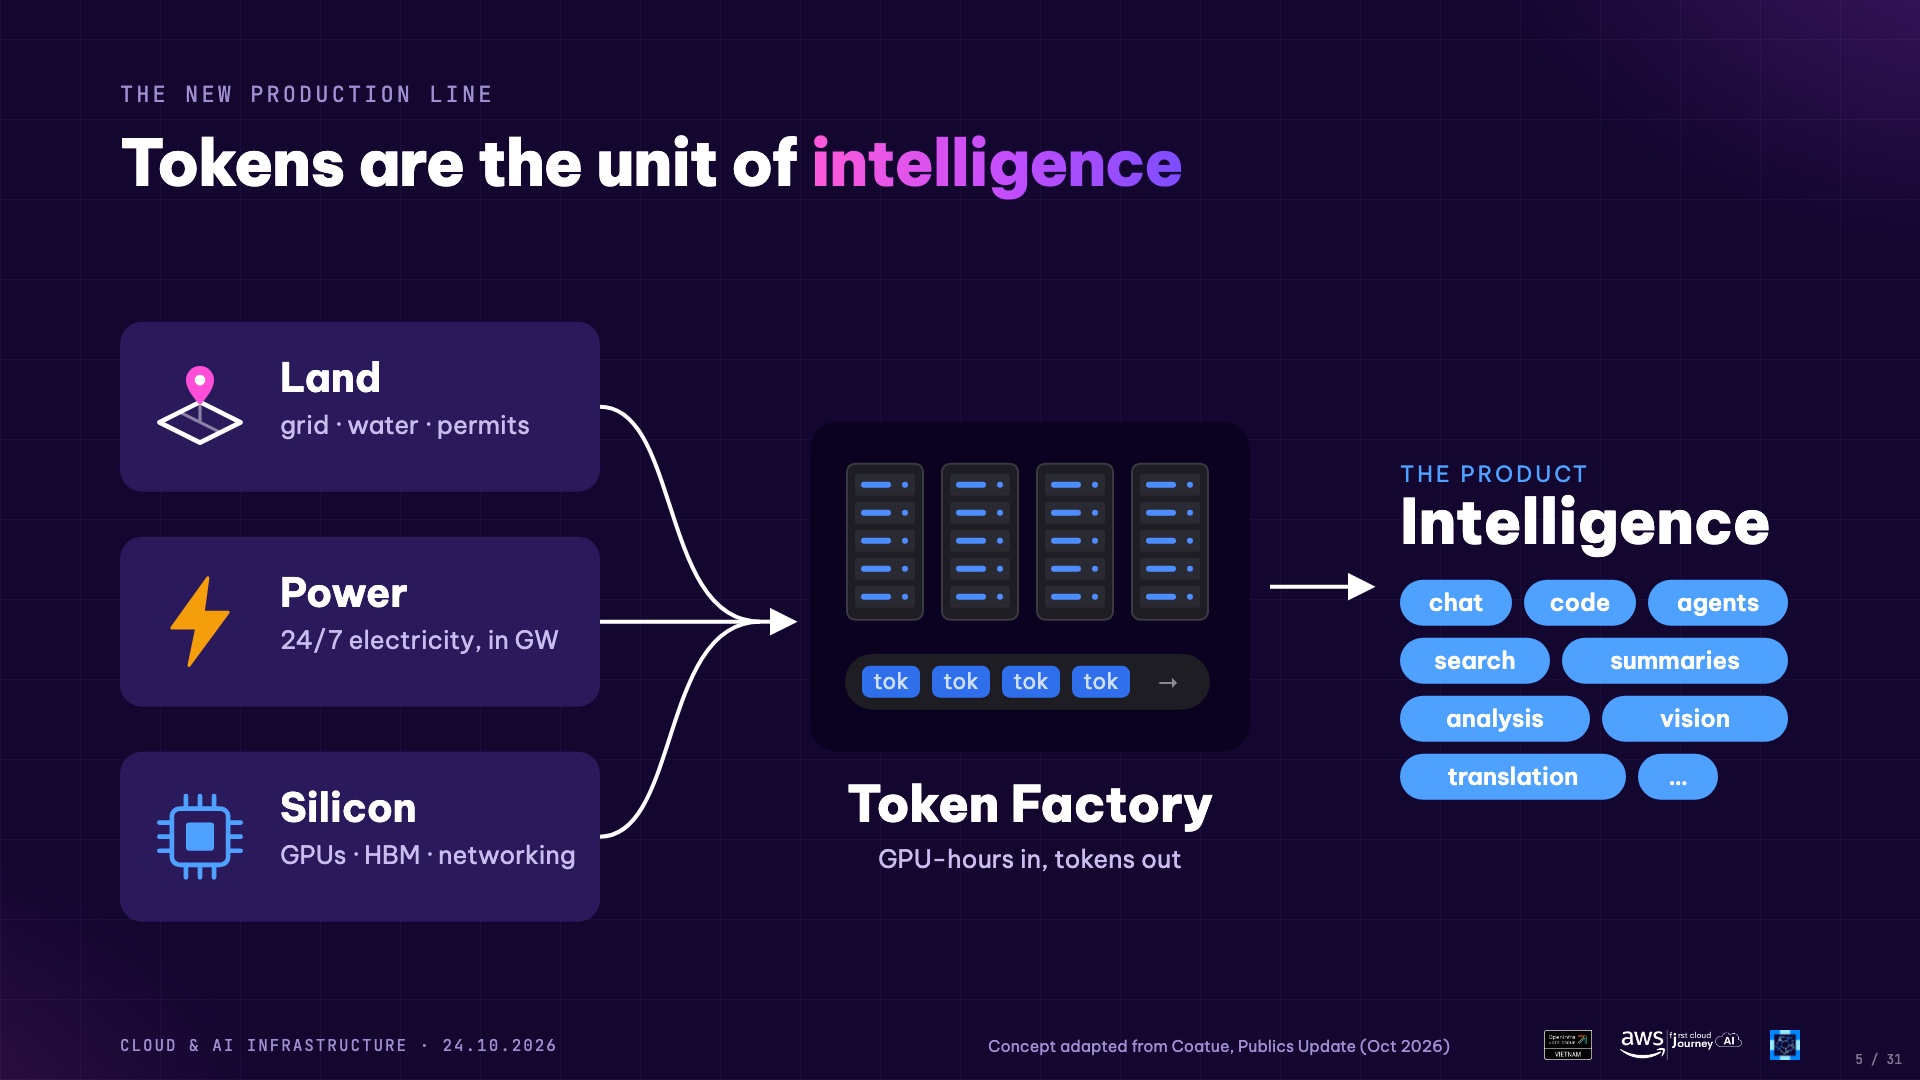
Phóng to cái hộp ở giữa thì bên trái là ba thứ phải có: đất, điện chạy 24/7, và silicon gồm GPU, HBM, network. Bên phải là thứ người dùng thật sự cần, từ chat, code, agent, search cho tới tóm tắt và dịch, và tất cả đều đi ra dưới dạng token. Cái hộp ở giữa là AI factory: GPU-hour đi vào, token đi ra, cũng chính là nửa đầu tên bài nói.
Đất và điện là chuyện của người xây data center. Buổi nói tập trung vào phần mềm bên trong cái hộp: làm sao một GPU-hour ra được nhiều token nhất, và làm sao để nhiều người dùng chung số token đó một cách an toàn.
Chúng ta đều bắt đầu từ đây
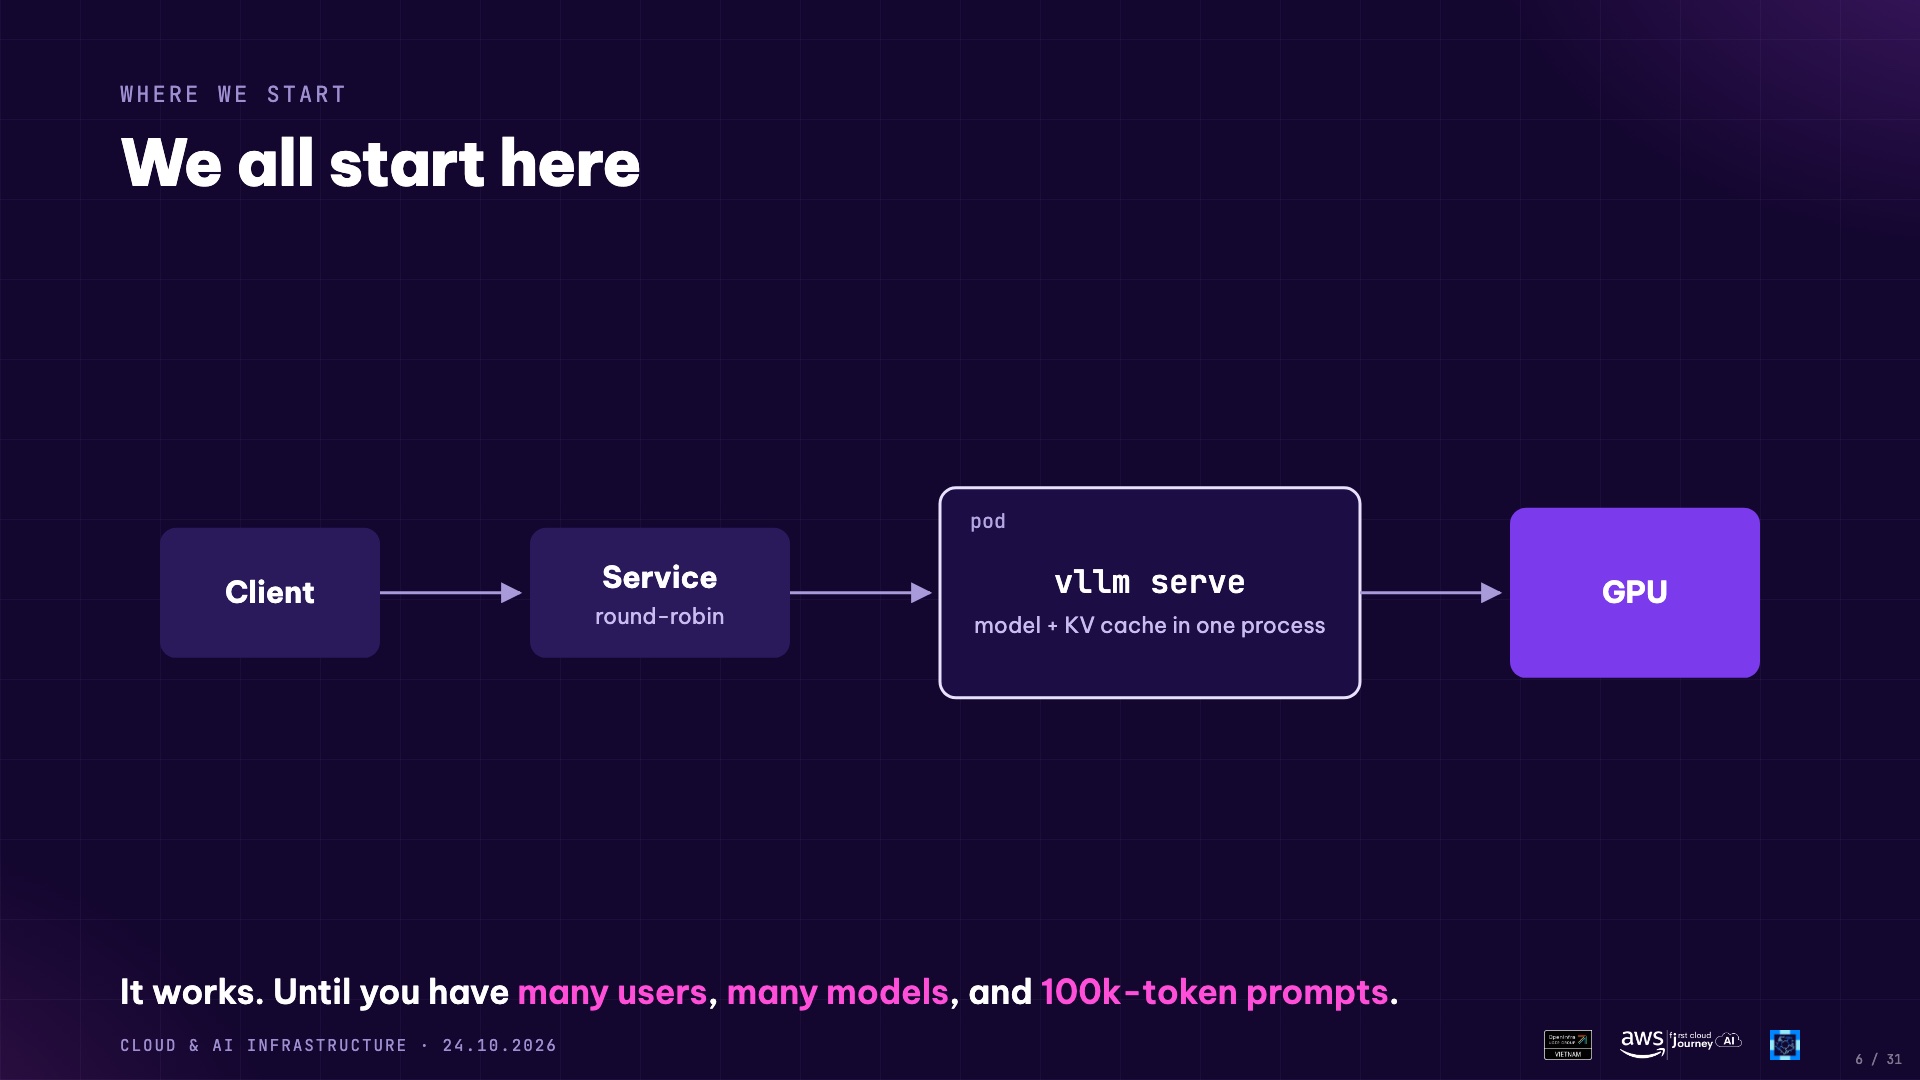
Cái hộp nhỏ nhất thì chắc ai cũng từng dựng: một pod chạy vllm serve, phía trước là một Kubernetes
Service chia đều request cho các pod. Cách này chạy tốt, với một nhóm nhỏ thì đủ dùng thật.
Nhưng khi có nhiều người dùng, mỗi người một API key và một hạn mức, nhiều model chạy cùng lúc, và nhất là prompt dài cả trăm nghìn token như với coding agent, thì từng chỗ một bắt đầu hỏng. Buổi nói đi qua những chỗ hỏng đó, mỗi chỗ thêm một component vào hệ thống.
Tách control plane và data plane
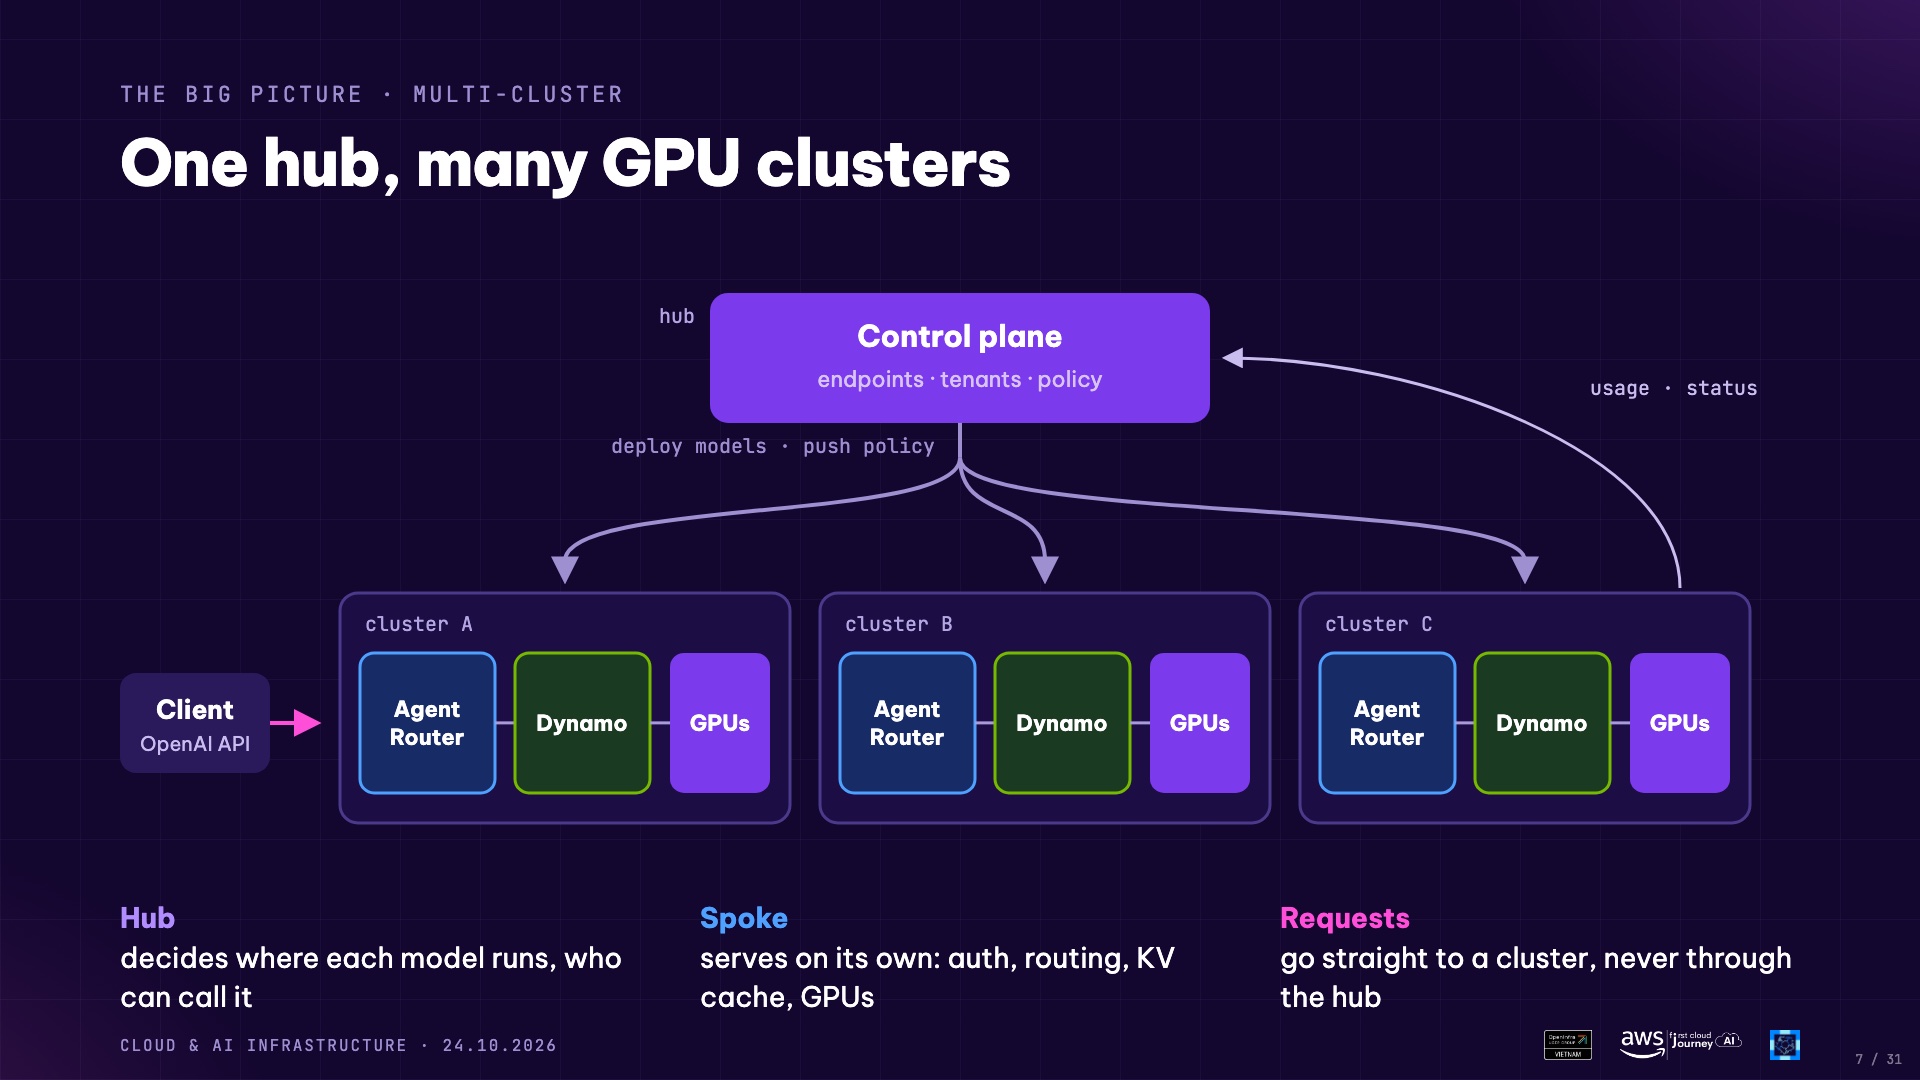
Bọn mình không chạy một cụm mà nhiều cụm GPU ở nhiều nơi, dựng vào những thời điểm khác nhau. Hình trên slide là hub-and-spoke, nhưng ý phía sau thì quen thuộc: tách phần ra quyết định khỏi phần phục vụ, giống cách Kubernetes tách API server với kubelet.
Hub là control plane, nơi tạo và xoá endpoint, quản lý tenant và policy, và quyết định model chạy ở cụm nào. Nó ghi trạng thái mong muốn xuống rồi đứng ngoài đường đi của request.
Mỗi spoke là data plane, một cụm GPU tự phục vụ được: Agent Router ở cửa, Dynamo ở giữa, GPU ở dưới. Request của người dùng đi thẳng vào spoke, không đi qua hub.
Thứ đi qua ranh giới giữa hai bên được giữ thật ít:
- Một bản khai báo deployment đi xuống (hiện là
DynamoGraphDeployment). - Một revision policy đi xuống, spoke kéo về cache local rồi ACK.
- Usage event và trạng thái đi lên.
Chính cái hợp đồng nhỏ đó cho bọn mình chỗ để mở rộng về sau:
- Phục vụ không phải chờ control plane. Không request nào phải đi một vòng về trung tâm, và nếu hub có trục trặc thì spoke vẫn phục vụ theo policy nó đang giữ.
- Mở rộng là thêm một spoke. Cụm mới chỉ cần tuân theo hợp đồng đó, không hơn.
- Thay hay nâng cấp từng component một. Bên trong spoke, các component cũng nói chuyện qua interface hẹp: gateway chỉ thấy một backend chuẩn OpenAI, Dynamo chỉ thấy engine như image của worker. Nâng Dynamo ở một cụm hay chuyển một endpoint từ vLLM sang SGLang không đụng gì tới hub. Ngược lại, control plane có thể đổi cách đặt model, ví dụ sau này giao việc chọn cụm cho Karmada, mà không đụng tới phần phục vụ.
Còn chưa làm được thì nói thẳng: một endpoint nằm trong một cụm, và chưa có failover tự động giữa các cụm. Phần còn lại của buổi nói là nhìn vào bên trong một spoke.
Phần 1: mỗi cụm một gateway
Phần này Minh nói. Mỗi cụm có một gateway riêng là
Agent Router, tên cũ là Envoy AI Gateway, từ tháng 9 là
project của Agentic AI Foundation. Nó hiểu request LLM, đọc trường model trong body để route. Phần lớn
việc nằm ở hai filter của Envoy: ext_authz gọi auth service trước khi request đi tiếp, còn ext_proc
phát usage event sau khi có response.
Danh tính và quyền vào. Client gửi API key và tên model, auth service kiểm key có hợp lệ không và có được dùng model đó không. Nếu hợp lệ, nó dựng một trusted context chứa danh tính người gọi, ghi vào header nội bộ.
Mọi giá trị về danh tính mà client tự gửi lên đều bị bỏ và ghi đè. Hạn mức chia ba tầng (platform và model, team, từng API key), mỗi tầng đặt được số request mỗi giây, số request đồng thời và hạn mức token. Phải qua hết mọi kiểm tra thì request mới tới model, trượt một cái là gateway trả 401, 403 hay 429 ngay, không tốn GPU.
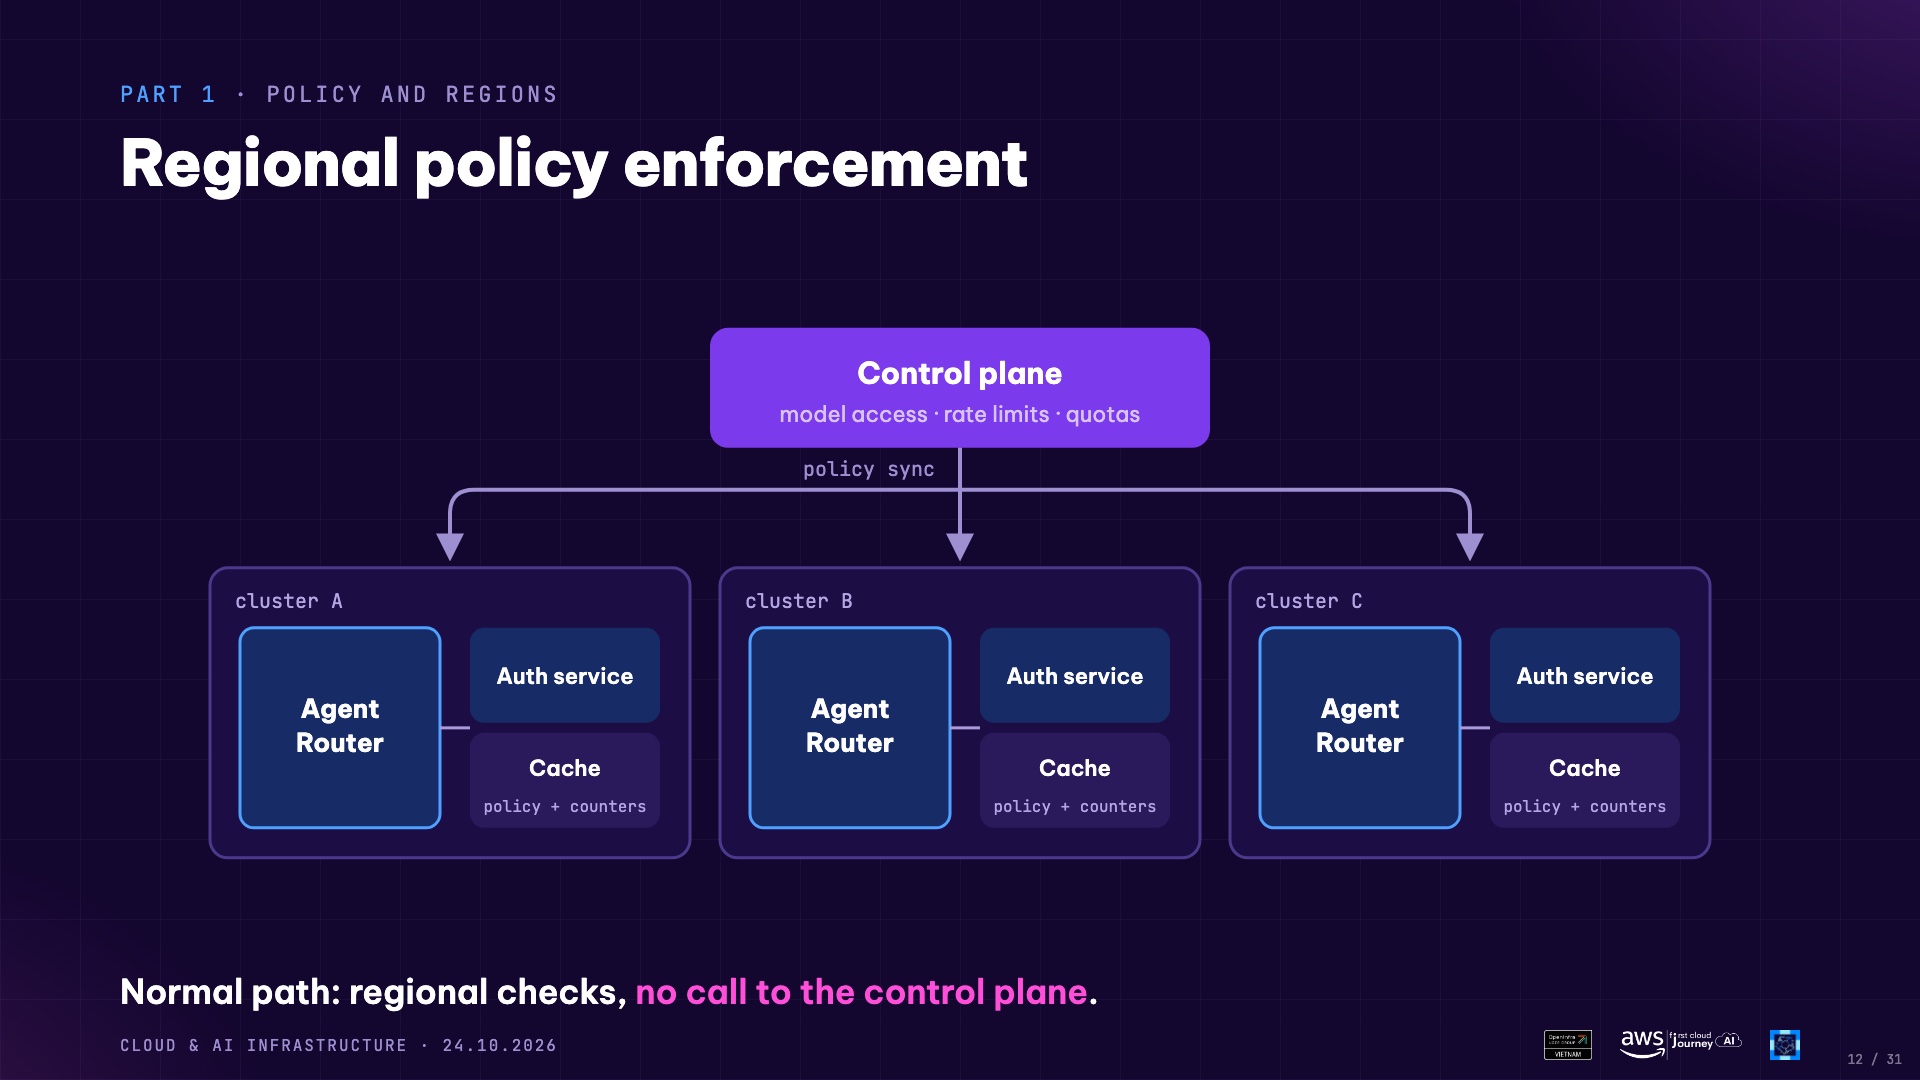
Policy kiểm tra ngay trong spoke. Nếu request nào cũng phải gọi về hub thì latency cộng thêm, và hub thành điểm chết chung của cả hệ thống. Nên mỗi cụm có auth service riêng cùng một cache giữ policy và bộ đếm, hub giữ quyền truy cập model, rate limit và quota rồi đồng bộ xuống. Đường đi bình thường của một request chỉ kiểm tra tại chỗ, không gọi về hub.
Cái giá là trạng thái giữa các vùng cập nhật có độ trễ, nên trong khoảng trễ đó usage có thể vượt hạn mức một chút. Bọn mình chấp nhận để đổi lấy latency, và để một vùng lỗi không kéo vùng khác.
Ba nguyên tắc giữ cả phần này: không có cửa phụ, auth lỗi thì đóng, và chỉ tin context đã xác minh.
Phần 2: mỗi GPU-hour ra nhiều token hơn
Phần sau mình nói. Trước khi vào Dynamo là bối cảnh: bọn mình gặp ba vấn đề và không cái nào nằm ở model. Endpoint agentic coding ra ít throughput trên mỗi GPU hơn mức phần cứng cho phép, scale thì bằng tay và chậm, còn engine thì chọn một lần lúc deploy rồi để đó, không có cách nào rẻ để kiểm lại. Ba vấn đề chung một gốc: chỗ sửa nằm phía trên inference engine.
Dynamo không phải inference engine, phần chạy model vẫn là vLLM, SGLang hay TensorRT-LLM. Dynamo nằm phía
trên: một frontend theo chuẩn OpenAI, một router chọn worker, một Planner lo scale, và một lớp KV cache
dùng chung, tất cả khai báo trong một DynamoGraphDeployment. Tóm tắt những gì bọn mình đo được:
- KV-aware routing và KV pool dùng chung. Prompt của coding agent có trung vị khoảng 83 nghìn token, khoảng 95% lặp lại từ các lượt trước, mà round-robin thì cứ bốn lượt có ba lượt rơi vào worker chưa từng thấy session đó. Route về worker đang giữ prefix, rồi thêm một pool trên RAM host (Mooncake Store) đọc qua RDMA, đưa cache hit từ 17% lên 29% rồi 82%.
- Cộng dồn trên hai node H200, thêm speculative decoding ở trên cùng: từ khoảng 340 lên khoảng 1.500 token output mỗi giây, gần 4,5 lần, không thêm phần cứng.
- Tách prefill và decode giảm ITL p99 một nửa, từ 53 xuống 26 ms, đổi lại khoảng 7% throughput. KV chuyển giữa các worker bằng NIXL qua RDMA trên mạng backend InfiniBand, tách khỏi mạng frontend Ethernet chở request và token.
- Scale theo KV-cache utilization thay vì GPU utilization: TTFT p95 từ 44,5 giây xuống 1,4 đến 3,4 giây.
- Chọn engine bằng cách đo. Với Qwen3.8-27B, SGLang hơn 26 đến 39% ở concurrency 32, nhưng bản sau có khi lại đảo, và trong Dynamo đổi engine chỉ là sửa một component.
Toàn bộ số liệu, cấu hình và lưu ý nằm trong bài viết.
Hai mạng dưới một request
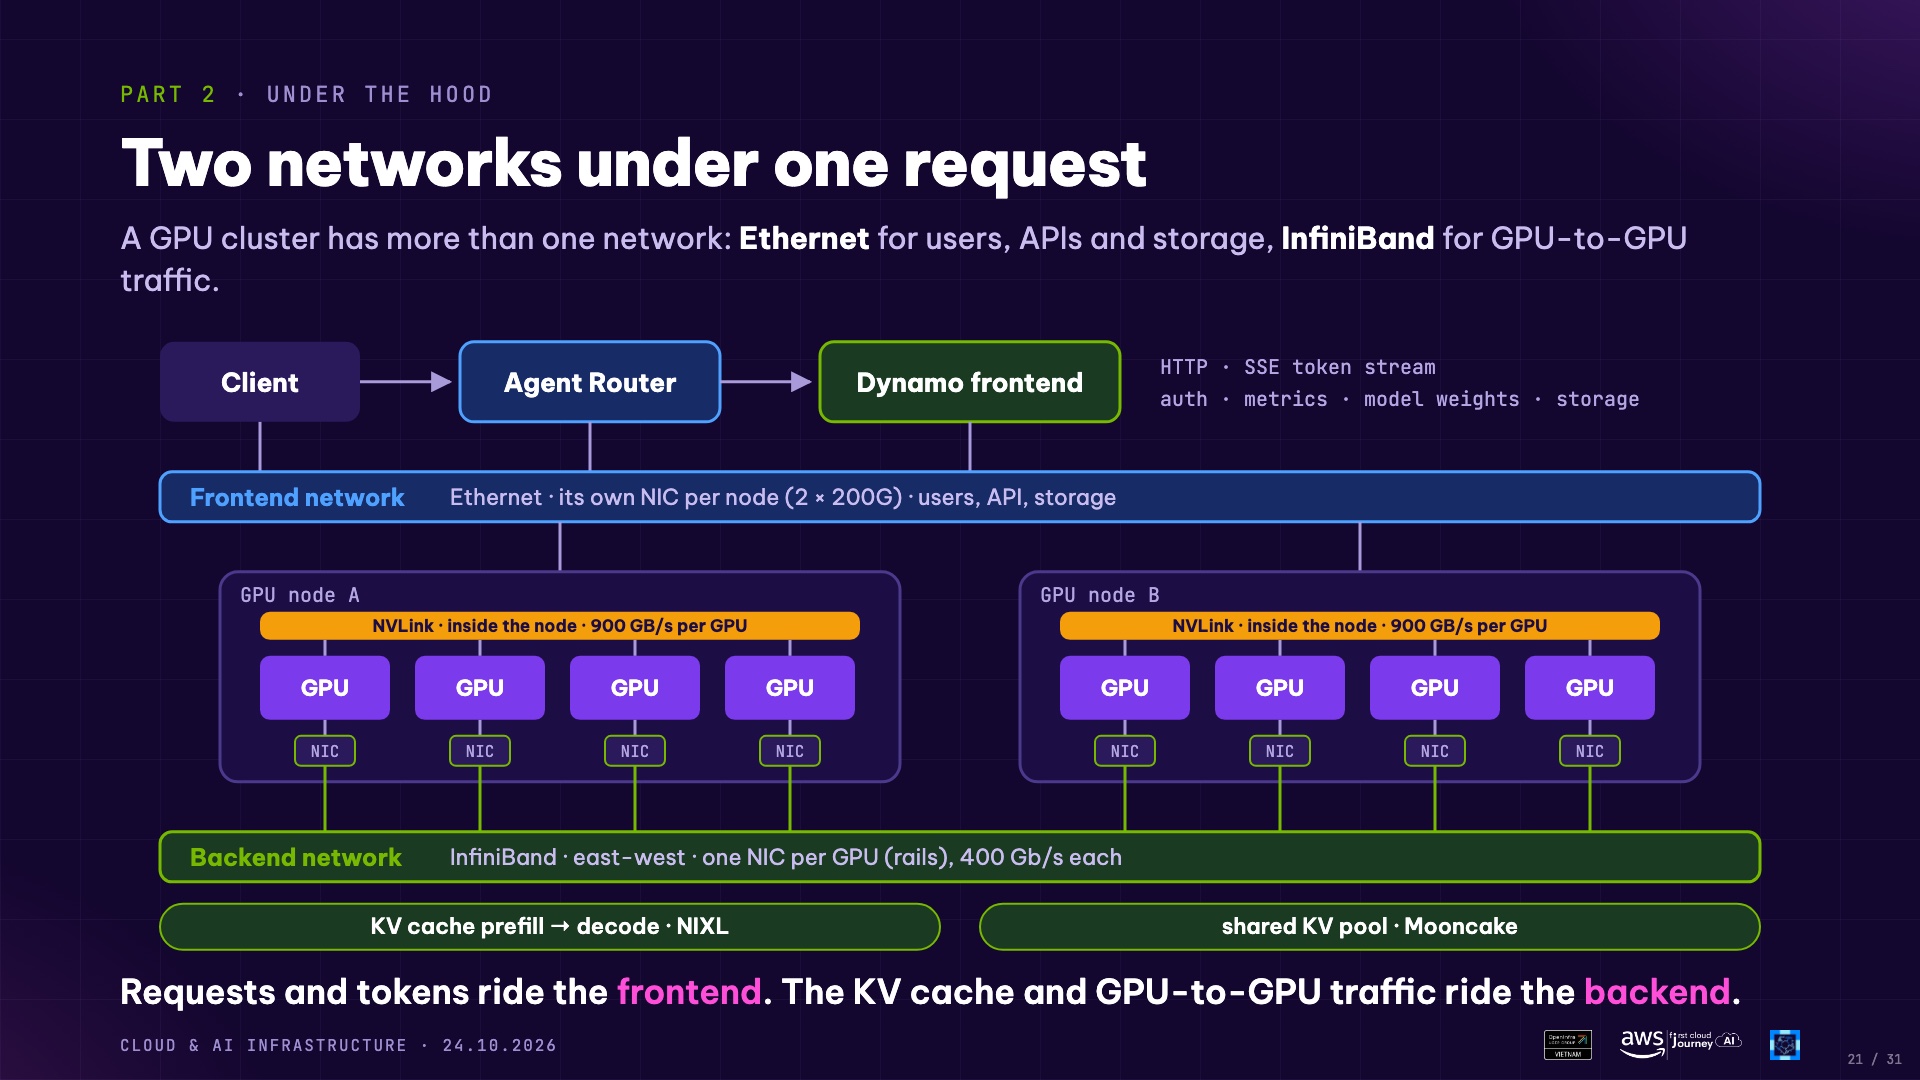
Phần mạng được hỏi nhiều hơn mình nghĩ, nên mình viết thêm một chút ở đây. Một request đi qua hai mạng khác nhau.
Mạng frontend là Ethernet thông thường, hướng north-south: client gọi vào Agent Router, Agent Router chuyển cho Dynamo frontend, token chảy ngược về client theo SSE. Control plane, metrics và kéo model weights từ storage cũng đi đường này. Mạng này có NIC riêng trên mỗi node, hai cổng 200G, cắm lên switch Ethernet và không dính gì tới fabric InfiniBand.
Mạng backend là mạng riêng của GPU, hướng east-west. Mỗi node HGX có 8 GPU, mỗi GPU một NIC InfiniBand 400 Gb/s riêng. Các NIC nối theo kiểu rail: GPU số 0 của mọi node cắm chung một leaf switch, GPU số 1 chung một leaf khác, cứ thế. Trong cùng một node thì GPU nói chuyện với nhau qua NVLink, khoảng 900 GB/s mỗi GPU, và để ý đơn vị: NVLink tính bằng gigabyte, còn InfiniBand tính bằng gigabit.
Trong setup này, thứ chạy trên mạng backend là KV cache, theo hai đường: từ prefill sang decode qua NIXL, và vào ra shared pool qua Mooncake.
Điều cần nhớ là nếu NIXL không tìm thấy đường RDMA thì nó lặng lẽ rơi xuống TCP: vẫn chạy, không báo lỗi, chỉ chậm đi hàng chục lần. Nên với P/D, RDMA là điều kiện bắt buộc chứ không phải tối ưu thêm.
“Lặng lẽ” còn theo kiểu ngược lại nữa: khi chạy P/D với NIXL qua UCX, KV đã chuyển xong mà request vẫn bị trả 500, vì lỗi nằm ở đoạn ghi metric sau khi truyền. Bọn mình gửi bản sửa lên vLLM và đã được merge (#57734).
Mỗi tầng quyết định một việc
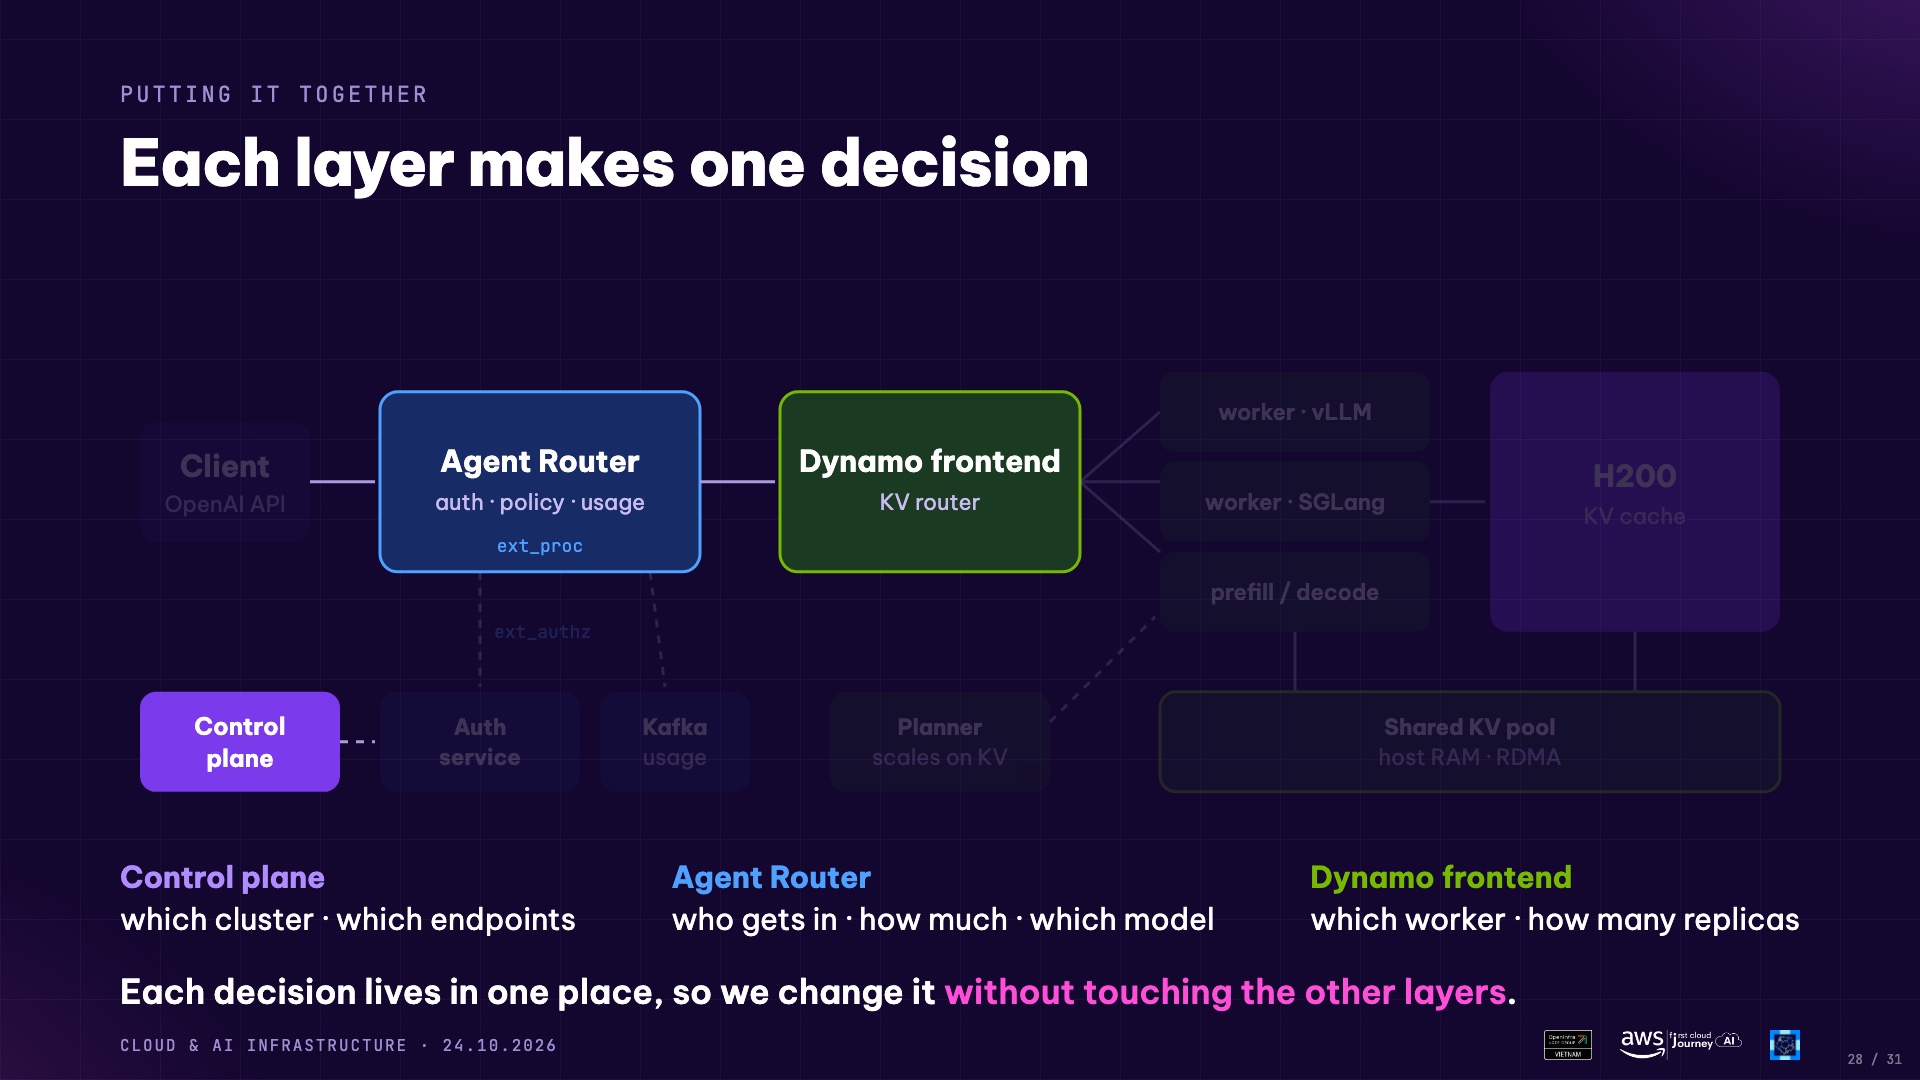
Ghép lại thì hub quyết định model chạy ở cụm nào. Trong cụm, Agent Router quyết định request có được vào không, được dùng bao nhiêu và đi tới model nào, còn Dynamo frontend quyết định request đi tới worker nào và cần bao nhiêu replica.
Mỗi quyết định nằm đúng một chỗ nên muốn đổi gì thì chỉ đụng một tầng. Đổi hạn mức thì sửa ở control
plane, gateway không phải deploy lại. Đổi engine hay tách prefill/decode thì sửa trong
DynamoGraphDeployment, gateway và control plane không biết gì. Và không tầng nào đoán thay tầng khác:
gateway không chọn worker theo KV cache, vì nó không nhìn thấy cache.
Tiếp theo: NVIDIA DSX OS
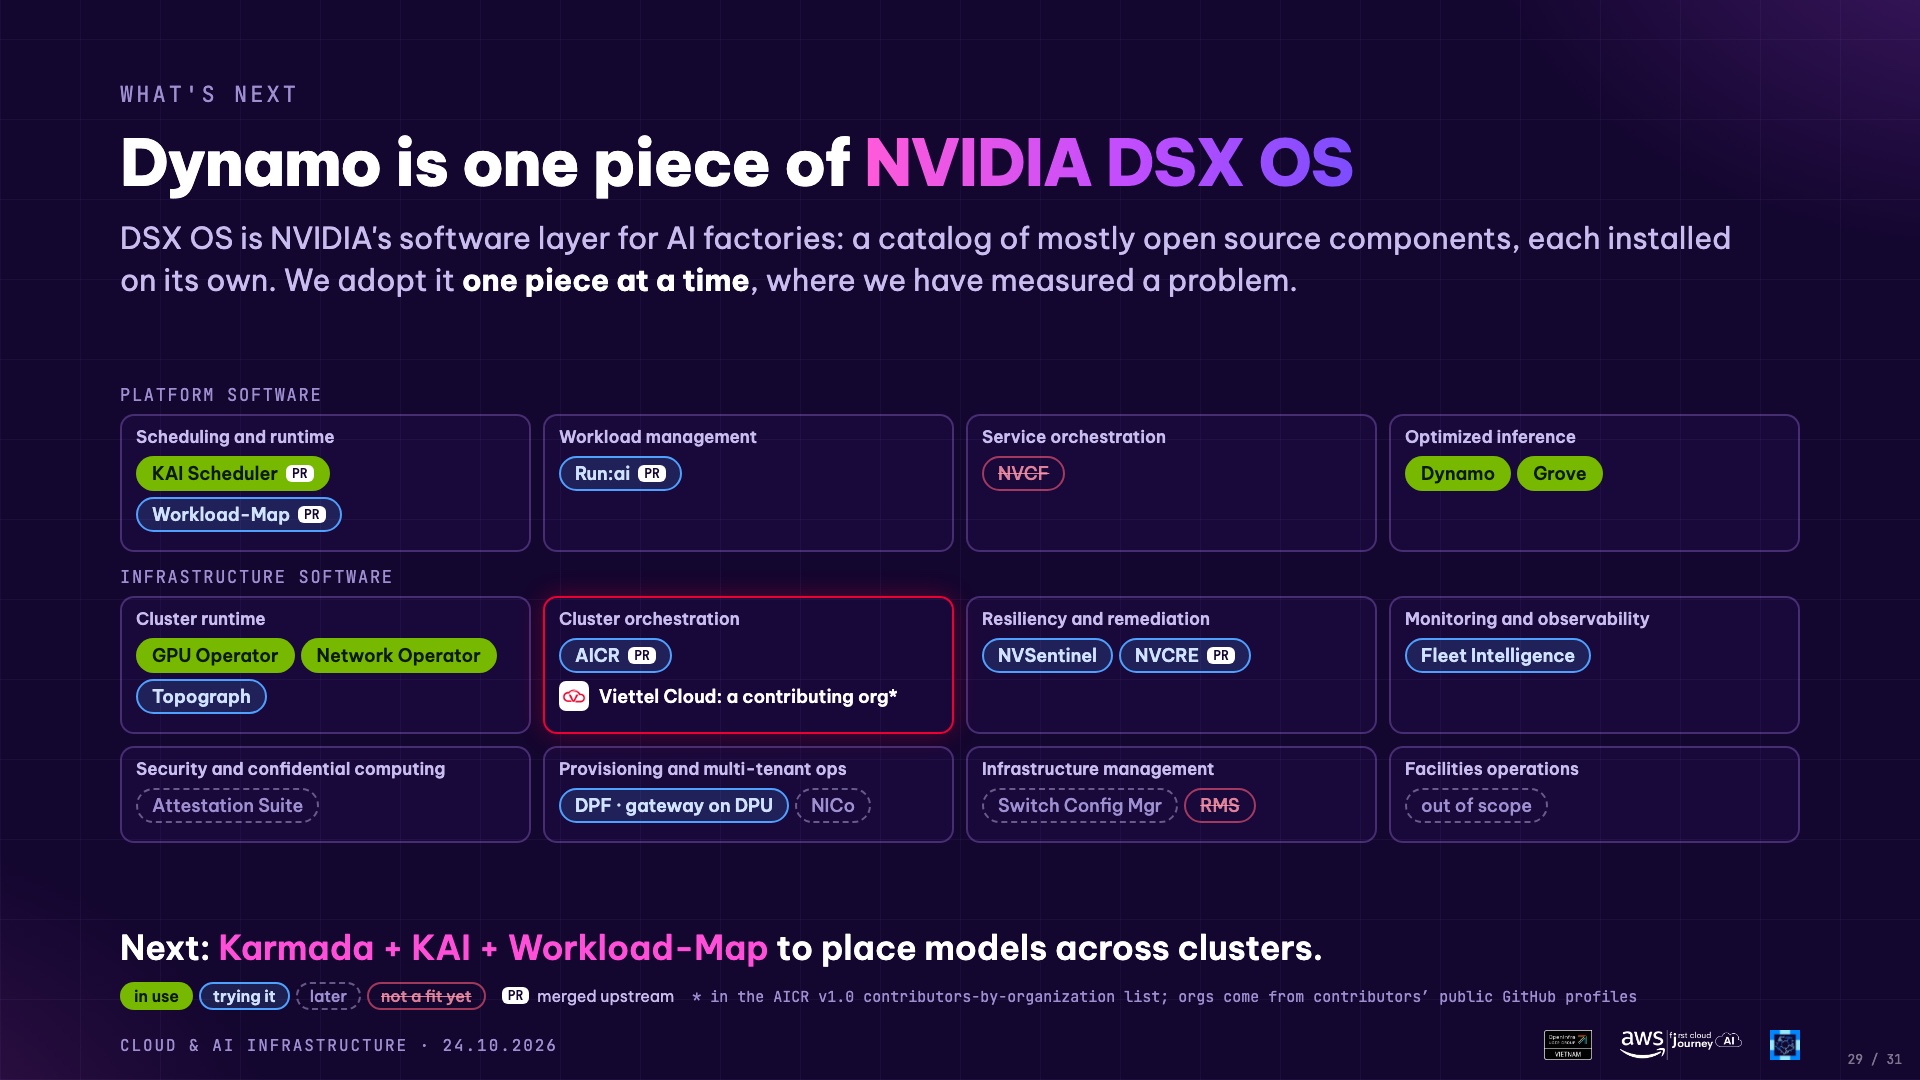
Bọn mình kết bằng NVIDIA DSX OS, bộ phần mềm mà Dynamo, Grove và KAI Scheduler thuộc về. Nó giống một kho package hơn là một hệ điều hành cài một lần, và bọn mình lấy từng component, chỉ khi component đó giải quyết một vấn đề đã đo được. Bản đồ ở trên là vị trí của từng component với bọn mình lúc này: đang dùng, đang thử, để sau, hoặc chưa hợp với phần cứng này, kèm những chỗ bọn mình đã có PR được merge upstream.
Phần nối thẳng với buổi nói là chọn cụm cho model: Karmada chọn cụm, KAI chia GPU trong cụm, Workload-Map để
các tầng cùng đọc được một DynamoGraphDeployment. Đó là bước tiếp theo chứ chưa xong. Mình hy vọng sắp tới
có dịp quay lại một buổi meetup để chia sẻ thêm về DSX OS, khi đã có kết quả đáng để kể.
Mọi người hỏi gì, và câu trả lời dài hơn
Trên sân khấu mình chỉ kịp trả lời ngắn từng câu. Phần dưới đây là câu trả lời đầy đủ hơn mà mình viết lại sau buổi nói, kèm số liệu và những lưu ý mà lúc đó mình chưa nhớ hết.
“Vendor khác thì sao? Một cụm chạy llm-d thay Dynamo được không?”
Hai câu này được hỏi riêng, nhưng chung một câu trả lời, và đó cũng chính là lý do phải tách control plane với data plane.
Hub độc lập với thứ chạy bên trong từng cụm. Hợp đồng giữa hai bên không nhắc gì tới phần cứng hay serving stack: một bản deployment đi xuống, một revision policy đi xuống, usage và trạng thái đi lên, và một endpoint chuẩn OpenAI đứng sau Agent Router.
Vì vậy mỗi spoke chọn được stack hợp với phần cứng của nó. Cụm A chạy GPU NVIDIA thì dùng Dynamo, còn cụm B dùng AI chip của vendor khác thì có thể chạy llm-d, hoặc stack mà vendor đó hỗ trợ tốt nhất. Hub chỉ cần một template deployment khác cho cụm B, còn người dùng vẫn thấy cùng một API.
Với llm-d thì chuyện này không xa vời: guide P/D của nó có sẵn cấu hình cho GPU AMD, Intel XPU, Google TPU
và mấy loại NPU, bên cạnh NVIDIA
(guide). Agent Router cũng route được
tới InferencePool, chính resource mà llm-d dùng, chứ không chỉ tới một service thường như Dynamo frontend
(docs).
Trên phần cứng NVIDIA, bọn mình chọn Dynamo vì một frontend lo được KV-aware routing, P/D và autoscale cho cả vLLM, SGLang và TensorRT-LLM, mà đổi engine theo benchmark là việc bọn mình làm thật. Đây không phải chuyện bên nào hơn: cả hai cùng chuyển KV bằng NIXL qua RDMA, NVIDIA là thành viên sáng lập llm-d, và KV router của Dynamo cũng chạy được như Endpoint Picker của llm-d.
Điều mình chưa dám nói: hiện mọi spoke của bọn mình đều là NVIDIA và đều chạy Dynamo. Một spoke không phải NVIDIA là điều kiến trúc cho phép, chứ bọn mình chưa làm. Việc thật sẽ là build lại engine, dựng mạng mới và đo lại từ đầu.
“Đo usage bất đồng bộ thì đánh đổi những gì?”
Usage được ghi ngoài đường đi của request: sau mỗi response, gateway phát một usage event, rồi metering xử lý sau, nên response không bao giờ phải chờ nó.
Được gì: metering có sự cố thì response vẫn trả, đường request không thêm bước nhảy nào, metering scale riêng, và hub có trục trặc thì spoke vẫn phục vụ trong giới hạn nó đang giữ.
Mất gì:
- Bộ đếm cập nhật trễ. Người gọi có thể vượt hạn mức usage trong khoảng trễ đó. Những kiểm tra bảo vệ GPU như số request mỗi giây hay số request đồng thời thì vẫn đồng bộ ngay tại spoke, chỉ phần ghi usage là bất đồng bộ.
- Event có thể tới hai lần, nên phần xử lý phải idempotent: mỗi request chỉ được tính một lần.
- Event có thể mất. Bất đồng bộ thì phải chứng minh được là không mất gì, tức là cần toàn vẹn từ đầu tới cuối, truy vết được và đối soát, và đây là phần tốn thời gian nhất để làm cho đúng.
- Streaming là chỗ nhiều trường hợp biên nhất. Số token cuối cùng chỉ có ở cuối stream, nên stream bị cắt giữa chừng là trường hợp đầu tiên cần test.
Làm lại thì mình vẫn chọn như vậy, vì gọi đồng bộ về một service trung tâm ở mỗi request là biến bài toán đo đếm thành bài toán availability.
Đọc thêm
- Slide của buổi nói
- Bài viết về Dynamo trên Viettel Cloud Tech Blog, có trong NVIDIA Dynamo External Publications.
- Agent Router, NVIDIA Dynamo, llm-d.
Cảm ơn ban tổ chức từ AWS First Cloud AI Journey, OpenInfra User Group Vietnam và Cloud Native Vietnam, và cảm ơn mọi người đã ở lại tới phần hỏi đáp.
Giữ control plane ngoài đường đi của request thì thêm một cụm, đổi một engine hay nâng một gateway chỉ là sửa ở một chỗ, chứ không thành một dự án mới. Nếu bạn cũng serve trên nhiều cụm mà vạch ranh giới ở chỗ khác, mình rất muốn nghe lý do :)