Hành trình lấy chứng nhận Kubernetes AI Conformance cho Viettel AI Platform
Đi lần lượt từng yêu cầu của bản v1.35: chuẩn đòi hỏi gì, và bọn mình đã chứng minh gì cho Viettel AI Platform.
Nhiều người nghĩ Kubernetes AI Conformance là một bộ test, chạy qua là có chứng nhận. Thực ra với bản v1.35, nó là một file YAML checklist kèm mấy file Markdown evidence do chính mình tự viết, CNCF review rồi đăng công khai trên GitHub cho ai cũng đọc được. Vậy nên thứ đáng đọc là evidence, không phải cái badge.
Tháng 4/2026 team mình đưa Viettel AI Platform qua chương trình này trên Kubernetes v1.35. Mình đã nhắc tới kết quả trong bài recap KCD Vietnam, còn bài này là bản đầy đủ: đi qua từng yêu cầu, chuẩn hỏi gì, bọn mình đưa ra cái gì, và những chỗ phải nối nhiều thành phần mới chạy được.
Kubernetes v1.35.3, containerd 2.2.2 và 1.7.28, NVIDIA GPU Operator với driver 580.126.09, Kueue v0.10.2. Số liệu trong repo kiểm tra ngày 25/10/2026.
Muốn có badge AI thì phải conformant trước đã
Bạn không bắt đầu từ chương trình AI được, vì platform phải Kubernetes Conformant trước, và checklist AI đòi đúng cái link đó ở phần metadata.
Kết quả conformance gốc của bọn mình vào repo cncf/k8s-conformance ngày 8/4, tức là một tuần sau khi
pull request AI đã mở, nên PR AI phải chờ. Lần chạy Ginkgo mất khoảng hai tiếng:
SUCCESS! -- 441 Passed | 0 Failed | 0 Pending | 6914 Skipped
PASS

Ginkgo ran 1 suite in 2h1m0.033057564s
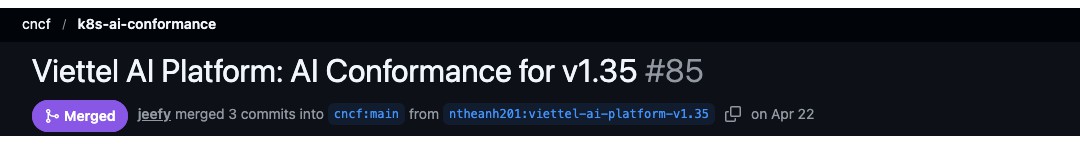
Pull request AI (#85) mở ngày 1/4 và được merge ngày 22/4 theo giờ Hà Nội. Chứng nhận có hiệu lực một năm.
Checklist v1.35 có mười hai mục, chín mục MUST và ba mục SHOULD. Mỗi mục có một trường status, một
danh sách file evidence và một dòng ghi chú. Evidence của bọn mình là chín file Markdown, toàn là lệnh
kubectl kèm output.
Evidence lấy từ hai node bare-metal Ubuntu 22.04 có GPU NVIDIA L40S và L40. Chứng nhận tính theo từng sản phẩm và từng cấu hình, nên đó chính là cấu hình được mô tả.
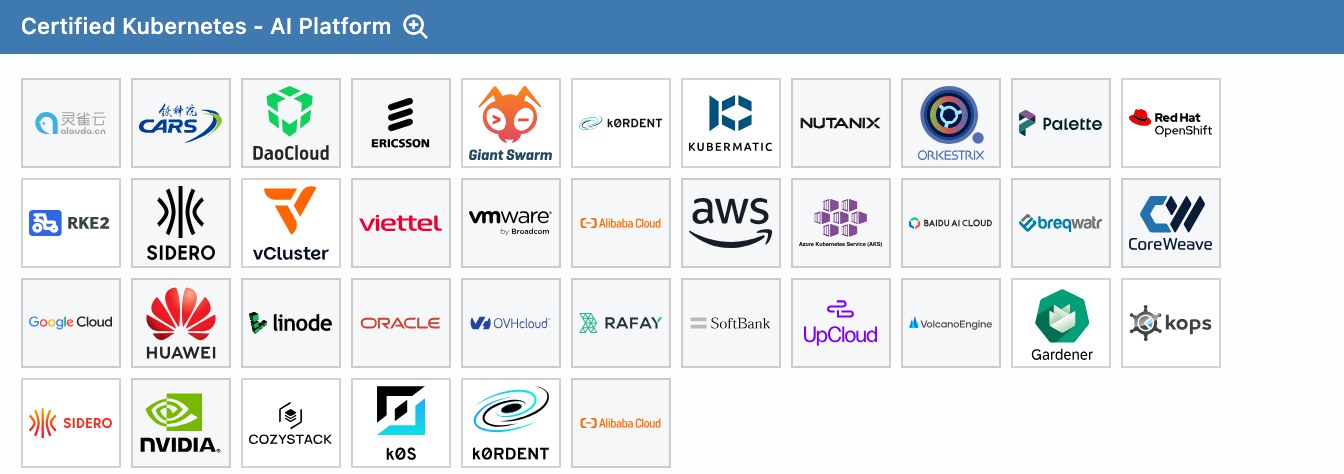
Tới ngày 25/10/2026, thư mục v1.35/ có 23 platform, còn cả repo có 40 platform khác nhau trải từ v1.33
tới v1.37. Viettel là vendor duy nhất từ Việt Nam trong danh sách đó.
DRA: API v1 có sẵn ngay từ đầu
Yêu cầu: “Support Dynamic Resource Allocation (DRA) APIs to enable more flexible and fine-grained resource requests beyond simple counts.”
Trên v1.35 thì resource.k8s.io/v1 đã GA và bật mặc định, nên cụm kubeadm không cần thêm flag nào cũng
serve được:
$ kubectl api-resources --api-group=resource.k8s.io
NAME                     SHORTNAMES   APIVERSION           NAMESPACED   KIND
deviceclasses                         resource.k8s.io/v1   false        DeviceClass
resourceclaims                        resource.k8s.io/v1   true         ResourceClaim
resourceclaimtemplates                resource.k8s.io/v1   true         ResourceClaimTemplate
resourceslices                        resource.k8s.io/v1   false        ResourceSlice
Bọn mình tạo một ResourceClaimTemplate xin một device thuộc class gpu.nvidia.com, cùng một pod tham
chiếu tới nó qua spec.resourceClaims:
apiVersion: resource.k8s.io/v1
kind: ResourceClaimTemplate
metadata:
  name: single-gpu
  namespace: dra-test
spec:
  spec:
    devices:
      requests:
      - name: req-0
        exactly:
          deviceClassName: gpu.nvidia.com
          allocationMode: ExactCount
          count: 1
API server nhận cả hai. Mà để ý block exactly nhé: ở bản v1, một device request hoặc là exactly với
đúng một lựa chọn, hoặc là firstAvailable với một danh sách lựa chọn xếp theo thứ tự ưu tiên.
Thêm một chi tiết cho ai đang xem trước các bản sau: checklist v1.36 và v1.37 không còn mục
dra_support riêng nữa.
Driver và runtime: phần nhàm chán để GPU Operator lo
Mục này là SHOULD, tức là platform nên có “a verifiable mechanism” để đảm bảo mọi node có accelerator đều có đúng driver và đúng cấu hình container runtime.
GPU Operator cài driver, một DaemonSet toolkit ghi cấu hình containerd, rồi một pod CUDA validator chạy
tới Completed trên từng node:
nvidia-container-toolkit-daemonset-q7jhl   1/1   Running     0   5h8m
nvidia-container-toolkit-daemonset-rgqwj   1/1   Running     0   28h
nvidia-cuda-validator-7hghr                0/1   Completed   0   27h
nvidia-cuda-validator-x72v5                0/1   Completed   0   5h7m
Hai node chạy hai bản containerd khác major (2.2.2 và 1.7.28), và validator vẫn chạy xong trên cả hai.
GPU sharing là một chủ đề riêng, mình đã kể cùng HAMi và số đo trong bài recap KCD.
Gateway API: Envoy Gateway lo phần route
Yêu cầu: có một implementation Gateway API cho traffic inference, “which enables capabilities like weighted traffic splitting, header-based routing (for OpenAI protocol headers), and optional integration with service meshes.”
Bọn mình dùng Envoy Gateway làm implementation, phía trên là Envoy AI Gateway (giờ là Agent Router) lo
LLM routing, chọn model backend và rate limit theo token. API group được serve đầy đủ, có cả
ListenerSet và TLSRoute ở bản v1.
Test tạo một GatewayClass, một Gateway, một HTTPRoute match theo host name và một backend Python
nhỏ. Khi Gateway báo PROGRAMMED: True thì gửi một request qua nó:
$ curl -v -H 'Host: test.example.local' http://<gateway-ip>:80/
> GET / HTTP/1.1
> Host: test.example.local
...
< HTTP/1.1 200 OK
< server: BaseHTTP/0.6 Python/3.11.15
...
Hello from Viettel AI Platform
Request đi vào Envoy, khớp HTTPRoute theo header Host, rồi tới được Service của backend.
Gang scheduling: Kueue nhận cả Job một lần
Yêu cầu: cài và chạy được “at least one gang scheduling solution that ensures all-or-nothing scheduling for distributed AI workloads (e.g. Kueue, Volcano, etc.)”
Bọn mình cài Kueue v0.10.2 từ release manifest, tạo một ResourceFlavor, một ClusterQueue quota 10 CPU
và 10Gi memory, một LocalQueue, rồi tạo một Job có parallelism: 3 gắn label tên queue.
Vậy all-or-nothing nằm ở đâu? Kueue suspend Job ngay khi tạo, sinh ra một Workload đại diện cho cả bộ
pod, và chỉ unsuspend khi cả bộ vừa quota. Nghĩa là quyết định “tất cả hoặc không” xảy ra lúc admission,
trước khi scheduler nhìn thấy pod nào.
$ kubectl get workloads -n gang-scheduling-test
NAME                      QUEUE          RESERVED IN    ADMITTED   FINISHED   AGE
job-gang-test-job-b942a   gang-test-lq   gang-test-cq   True       True       83s
Ba pod ghi log thời điểm bắt đầu là 09:29:23, 09:29:24 và 09:29:25, và cả ba đều chạy xong.
Một mẹo nếu bạn dựng tiếp trên cái này: Kueue admit theo quota chứ không theo node còn trống, nên nếu cần
các pod thực sự khởi động cùng nhau thì xem thêm waitForPodsReady.
Cluster autoscaling: chữ “nếu” quan trọng với bare metal
Yêu cầu mở đầu bằng một điều kiện: “If the platform provides a cluster autoscaler or an equivalent mechanism, it must be able to scale up/down node groups containing specific accelerator types based on pending pods.”
Trên bare metal thì không có node group nào để scale. Một server GPU mới join bằng kubeadm join, sau
đó GPU Operator cài driver, cấu hình runtime và advertise GPU lên node:
NODE         GPU   CPU
gpu-node-1   2     96
gpu-node-2   2     96
Với kiểu triển khai này thì autoscaling diễn ra ở mức pod, cũng chính là yêu cầu tiếp theo.
Pod autoscaling: từ DCGM tới HPA
Yêu cầu: HPA phải chạy đúng với pod dùng accelerator, “including the ability to scale these Pods based on custom metrics relevant to AI/ML workloads.”
Làm CPU trước thì đơn giản: cài metrics-server, thêm --kubelet-insecure-tls vì kubelet trên mấy node bare-metal này
dùng certificate mà metrics-server không verify được, rồi tạo tải lên một web server nhỏ. HPA tăng từ 1
lên 10 replica ở mức cpu: 436%/20%, rồi về lại 1 khi hết tải.
Sau đó tới GPU metric. Commit ngày 17/4 mở rộng phần này để cho thấy scale-out dưới tải GPU thật: một vòng lặp PyTorch nhân hai ma trận 8192×8192.
Pipeline có bốn phần: DCGM exporter gắn vào mỗi series GPU label namespace, pod và container của
pod đang giữ device đó, Prometheus scrape các pod exporter, rồi Prometheus Adapter biến series đó thành
custom metric:
rules:
  custom:
    - seriesQuery: 'DCGM_FI_DEV_GPU_UTIL{namespace!="",pod!=""}'
      resources:
        overrides:
          namespace: {resource: "namespace"}
          pod: {resource: "pod"}
      name:
        matches: "DCGM_FI_DEV_GPU_UTIL"
        as: "dcgm_fi_dev_gpu_util"
      metricsQuery: 'avg_over_time(DCGM_FI_DEV_GPU_UTIL{<<.LabelMatchers>>}[2m])'
Còn HPA thì target nó như một metric kiểu Pods với averageValue: "50". Pod đứng ở 100 nên:
Events:
  Normal  SuccessfulRescale  38s   horizontal-pod-autoscaler  New size: 2; reason: pods metric dcgm_fi_dev_gpu_util above target
  Normal  SuccessfulRescale  8s    horizontal-pod-autoscaler  New size: 4; reason: pods metric dcgm_fi_dev_gpu_util above target
Có hai chi tiết trong rule đó làm phần việc chính. namespace!="",pod!="" loại các GPU không có pod nào
giữ, nên card rảnh không kéo trung bình xuống. Và DCGM_FI_DEV_GPU_UTIL là số đo ở mức device, nó khớp
gọn với một pod ở đây vì mỗi pod giữ trọn một GPU.
Accelerator metrics: đọc thẳng endpoint gốc
Yêu cầu: ít nhất một giải pháp metrics có utilization và memory theo từng accelerator, thêm nhiệt độ, công suất và interconnect bandwidth nếu phần cứng có, ở định dạng chuẩn mà máy đọc được.
DCGM exporter đi kèm GPU Operator và nghe ở port 9400. Bọn mình curl nó từ trong cụm và đăng nguyên các dòng output, ở đây cắt bớt:
DCGM_FI_DEV_SM_CLOCK{gpu="0",...,modelName="NVIDIA L40S",Hostname="gpu-node-1",DCGM_FI_DRIVER_VERSION="580.126.09"} 210
DCGM_FI_DEV_GPU_TEMP{gpu="0",...,modelName="NVIDIA L40S",...} 32
DCGM_FI_DEV_POWER_USAGE{gpu="0",...,modelName="NVIDIA L40S",...} 34.156000
DCGM_FI_DEV_GPU_UTIL{gpu="0",...,modelName="NVIDIA L40S",...} 0
DCGM_FI_DEV_FB_FREE{gpu="0",...,modelName="NVIDIA L40S",...} 45457
DCGM_FI_PROF_PIPE_TENSOR_ACTIVE{gpu="0",...,modelName="NVIDIA L40S",...} 0.000000
Series nào cũng mang label DCGM_FI_DRIVER_VERSION, nên đây cũng là một cách kiểm chéo miễn phí cho mục
driver ở trên.
AI service metrics: Alloy thu thập, Prometheus cấp số cho HPA
Yêu cầu: một hệ thống monitoring có thể tự discover và thu metrics từ các workload expose theo định dạng chuẩn, ví dụ Prometheus exposition.
Grafana Alloy lo phần thu thập chung: /metrics của KServe controller ở port 8080, /stats/prometheus
của Envoy cho AI gateway, và DCGM exporter. Một Prometheus server scrape DCGM exporter cho Prometheus
Adapter, rồi Adapter serve custom.metrics.k8s.io cho HPA ở phần trên.
Secure accelerator access: pod không xin GPU thì không thấy gì
Yêu cầu: quyền truy cập accelerator từ container phải được “properly isolated and mediated by the Kubernetes resource management framework (device plugin or DRA) and container runtime.”
Test gồm hai pod, trong đó pod đầu không xin GPU:
=== Test: Pod WITHOUT GPU request ===
PASS: No GPU devices visible (expected)
nvidia-smi check:
sh: 8: nvidia-smi: not found
PASS: nvidia-smi not available (expected)
Container đó thậm chí không có cả binary nvidia-smi. Vì sao vậy? Container toolkit chỉ inject device
node và file driver cho những device mà device plugin đã cấp, nên không xin thì không có gì được inject.
Pod thứ hai xin nvidia.com/gpu: 1:
=== Test: Pod WITH GPU request ===
GPU 0: NVIDIA L40 (UUID: GPU-c3c7096e-db9d-322f-efd9-510971f3d33c)
---
/dev/nvidia-modeset
/dev/nvidia-uvm
/dev/nvidia-uvm-tools
/dev/nvidia1
/dev/nvidiactl
Chỉ có một device node GPU là nvidia1 cùng mấy device điều khiển. Node đó còn nvidia0 nữa nhưng pod
không nhìn thấy.
Robust controller: KServe, có cả webhook
Yêu cầu: ít nhất một AI operator phức tạp có CRD cài được và chạy ổn định, tức là pod chạy, webhook trả lời, custom resource được reconcile.
Bọn mình dùng KServe: bảy CRD, trong đó có LLMInferenceService với llmisvc-controller-manager riêng,
một mutating và bảy validating webhook configuration, chín ClusterServingRuntime đã reconcile từ
HuggingFace tới TensorFlow Serving. Sau đó tạo một InferenceService:
apiVersion: serving.kserve.io/v1beta1
kind: InferenceService
metadata:
  name: sklearn-iris
  namespace: kserve-test
spec:
  predictor:
    sklearn:
      storageUri: "gs://kfserving-examples/models/sklearn/1.0/model"
Validating webhook nhận resource này và controller nhận nó vào vòng reconcile. Vậy là đủ cả ba thứ yêu cầu nêu ra: pod của controller, webhook và một custom resource được reconcile.
Vòng sau sẽ khác
Từ v1.37 chương trình khuyến nghị chạy bộ test AI
Conformance của upstream và đính kèm
junit.xml hoặc e2e.log cho các mục mà bộ test có. Hiện bộ test đã có test cho gang scheduling,
cluster autoscaling, driver và runtime management, và AI service metrics. Test runner kiểm cùng một thứ
theo cùng một cách cho mọi platform.
Badge chỉ là một cái logo trên trang landscape, còn evidence là mười file trên GitHub mà ai cũng đọc được. Của bọn mình ở đây. Nếu bạn đang chuẩn bị submission và kẹt ở mục nào thì cứ đọc thử rồi email mình nhé.